Projet personnel / Architecture moteur

Tessera Engine

Un moteur de jeu construit autour de responsabilités explicites et de décisions mesurées.

Tessera est le moteur de jeu et l’éditeur Windows que je développe en C++20, avec Direct3D 12 et l’Agility SDK. J’écris l’ECS, le système de jobs, le pipeline d’assets et le moteur de rendu. Cette étude explique leurs relations, les raisons de leurs frontières et les moyens employés pour vérifier leur fonctionnement.

Les décisions sont mesurées plutôt que supposées. Tests par sous-système, sondes en ligne de commande, références de benchmark et comparaisons d’images accompagnent l’implémentation. Le dépôt est privé ; l’architecture, les captures et les mesures présentées ici donnent une vue technique du travail en cours.

  • C++20
  • Windows
  • Direct3D 12
  • Dear ImGui
  • Sharpmake
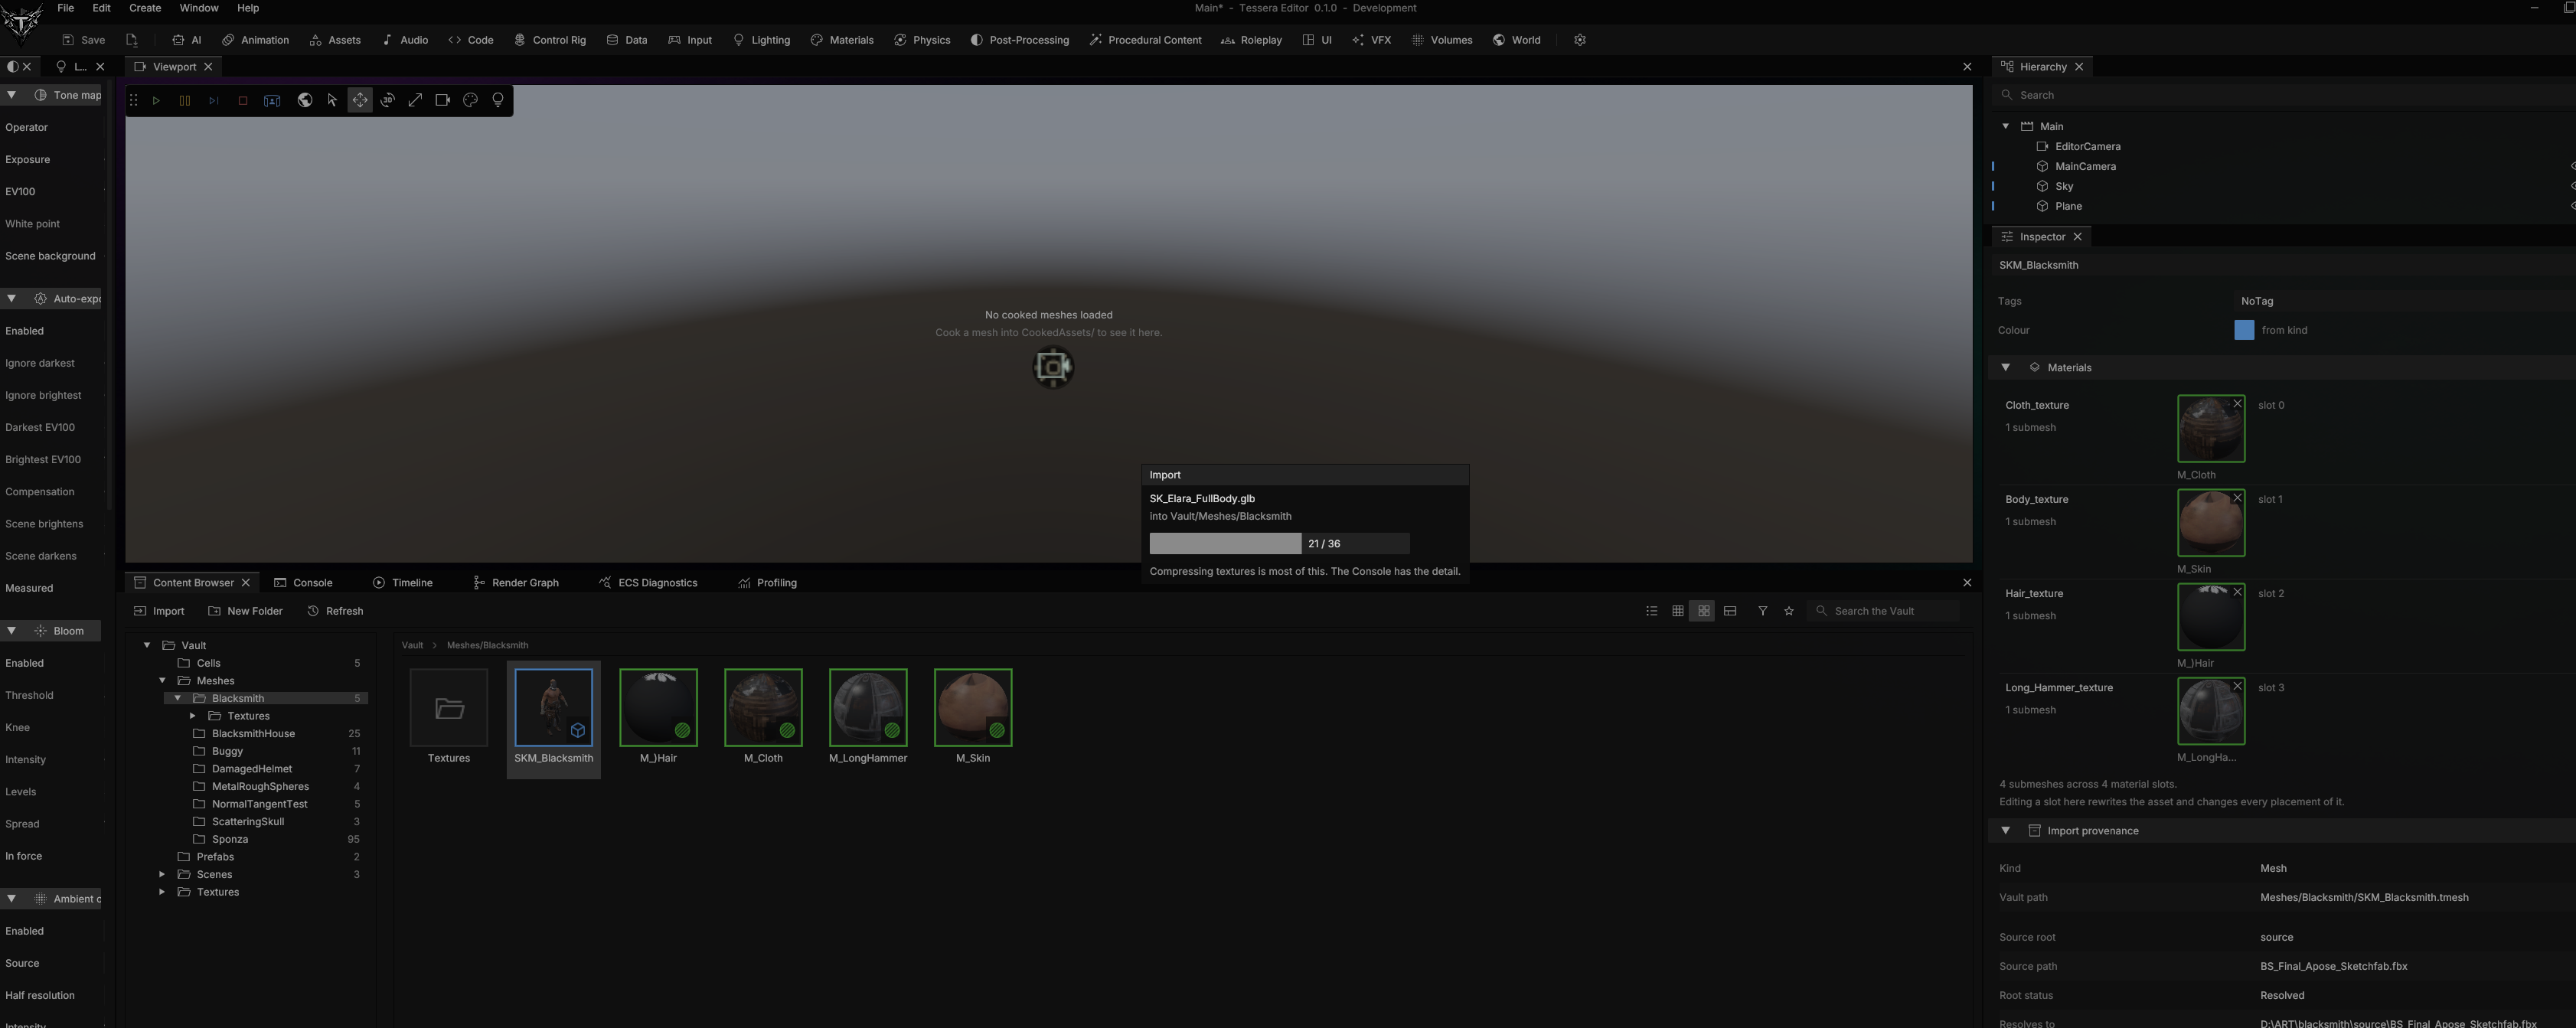
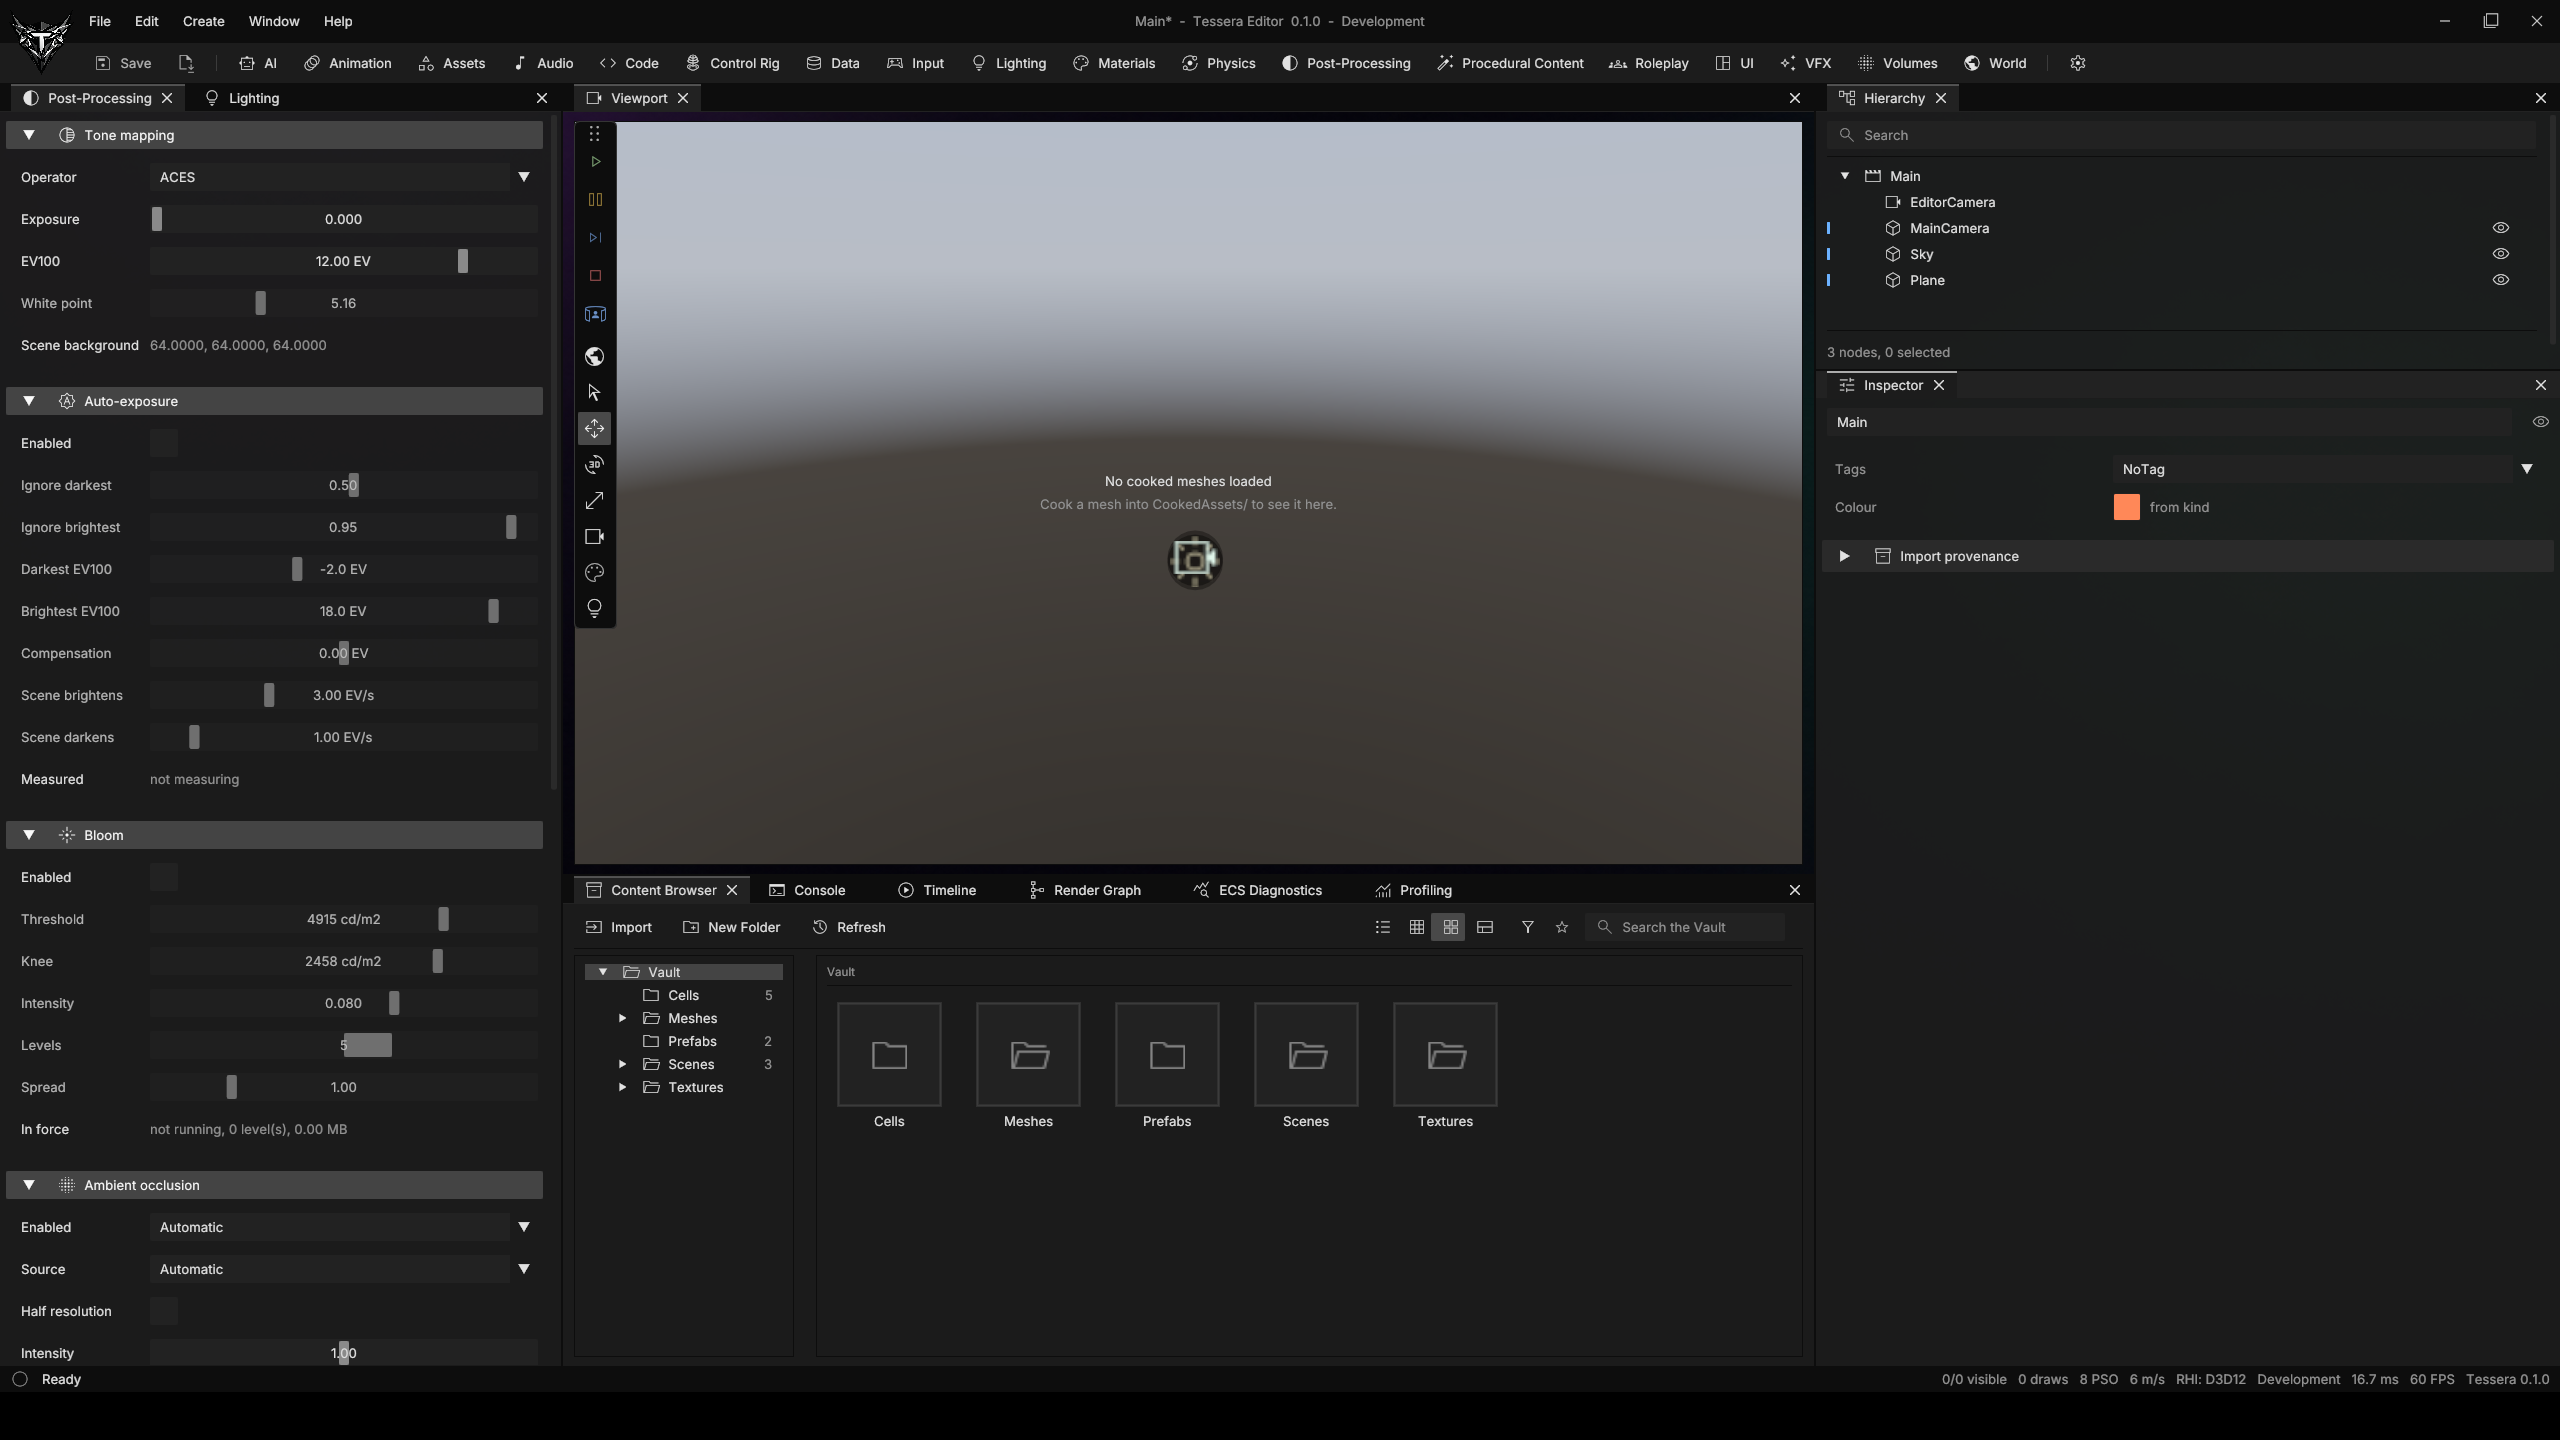
Vue de l’éditeur avec docking, viewport, hiérarchie, inspector et Content Browser ; cette capture montre une scène sans meshes préparés chargés.
Vue de l’éditeur avec docking, viewport, hiérarchie, inspector et Content Browser ; cette capture montre une scène sans meshes préparés chargés. Ouvrir l’original dans un nouvel onglet

Présentation

De petites pièces, des frontières vérifiables

Une tessera est une pièce de mosaïque. Chaque couche possède une responsabilité et une direction de dépendance définies. La simulation ne dépend pas du rendu ; le moteur de rendu construit un plan ; le backend graphique traduit ce plan en travail GPU. L’éditeur utilise le moteur qu’il inspecte.

Mon précédent moteur Hibou utilisait OpenGL, EnTT et un éditeur WPF. Tessera applique ces expériences à la mémoire et à la synchronisation explicites du GPU, à un ECS organisé pour l’ordonnancement et à un éditeur C++ dans le même processus. Le moteur est une bibliothèque statique : les exports D3D12SDKVersion et D3D12SDKPath de l’Agility SDK appartiennent à l’exécutable. Cette frontière explicite évite une organisation fragile en DLL.

Dépendances

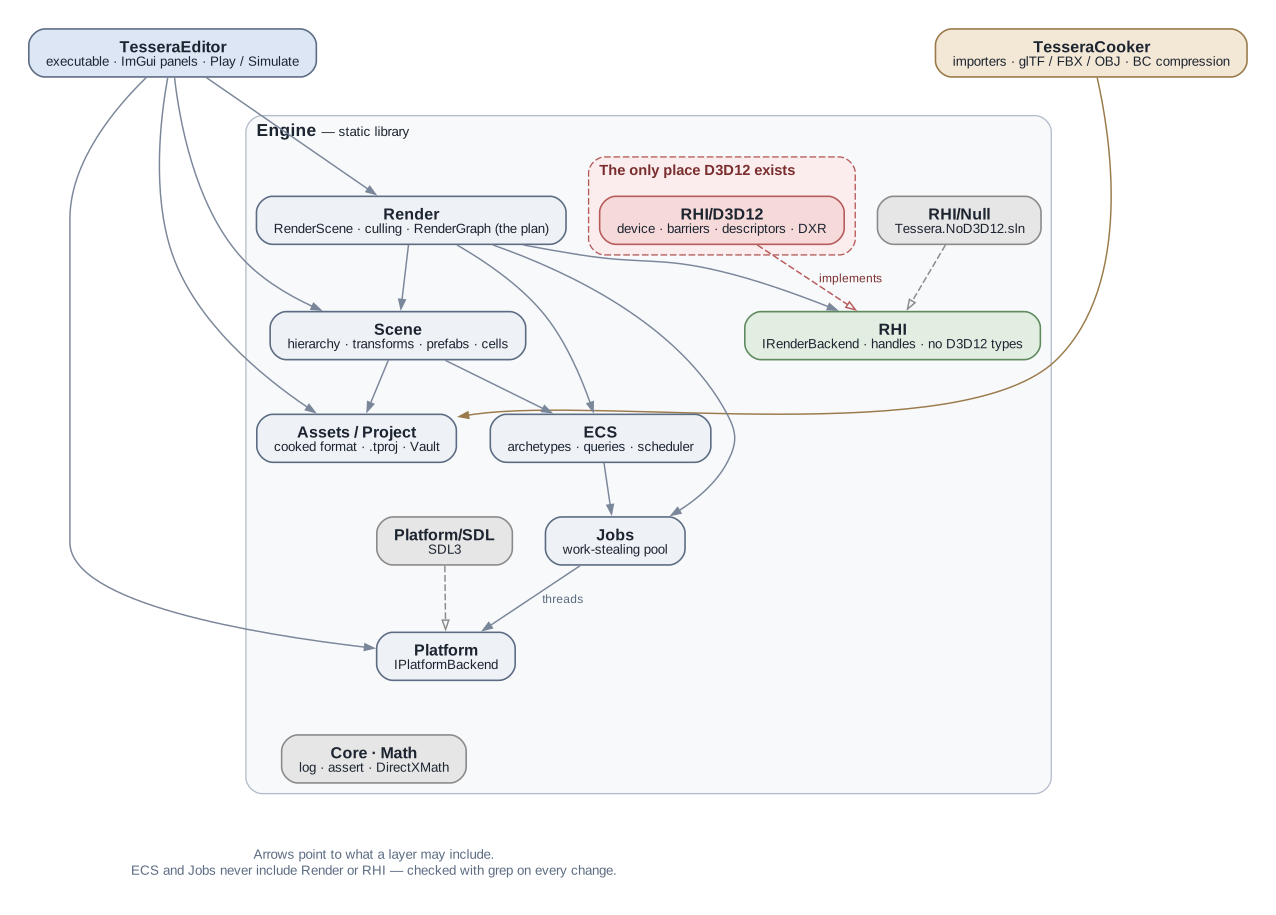
Architecture en couches

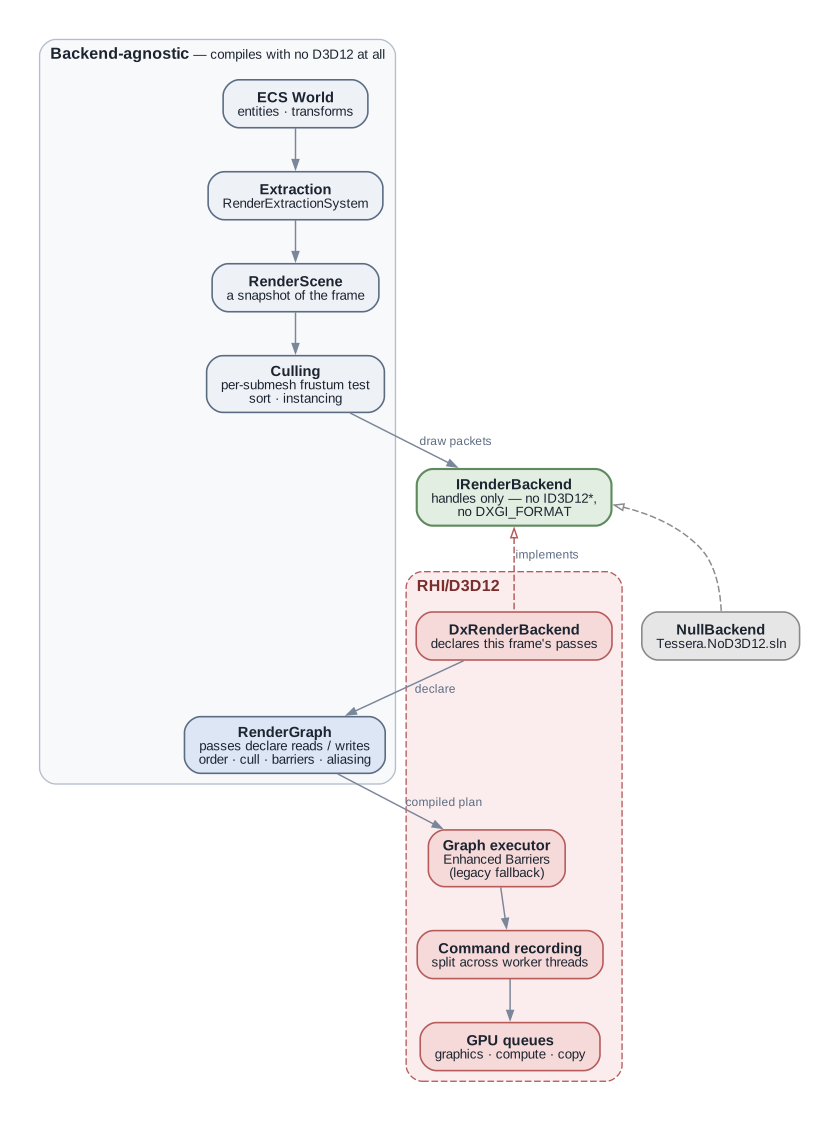
Les frontières sont imposées par les dossiers autant que par les interfaces. Seule Platform parle à SDL3 ; seul RHI/D3D12/ inclut les headers Direct3D. Render décide quoi dessiner sans enregistrer de commandes GPU. ECS, Jobs et Scene n’incluent ni Render/ ni RHI/ ; Assets et Project restent aussi indépendants du rendu.

Les bibliothèques d’import et de compression appartiennent exclusivement à Tools/TesseraCooker. Le runtime consomme les données préparées sans dépendances d’authoring. Des recherches d’includes vérifient ces règles, mais la compilation fournit une preuve plus forte : Tessera.NoD3D12.sln compile moteur et éditeur avec un backend nul et une interface SDL_Renderer. Un type D3D12 qui fuit casse cette solution ; ses builds produisent zéro objet Dx*.obj.

Couches de dépendance du moteur et frontière isolée de Direct3D 12.
Couches de dépendance du moteur et frontière isolée de Direct3D 12. Ouvrir l’original dans un nouvel onglet

Simulation

Un ECS maison conçu pour l’ordonnancement

J’ai étudié EnTT et Flecs, puis construit un ECS autour de trois exigences : accès en lecture/écriture déclarés, changements structurels différés et déterministes, et snapshots du monde. Une Entity contient un index et une génération sur huit octets ; la génération détecte les références périmées. La persistance utilise un UUID, StableEntityId, et non un handle du runtime.

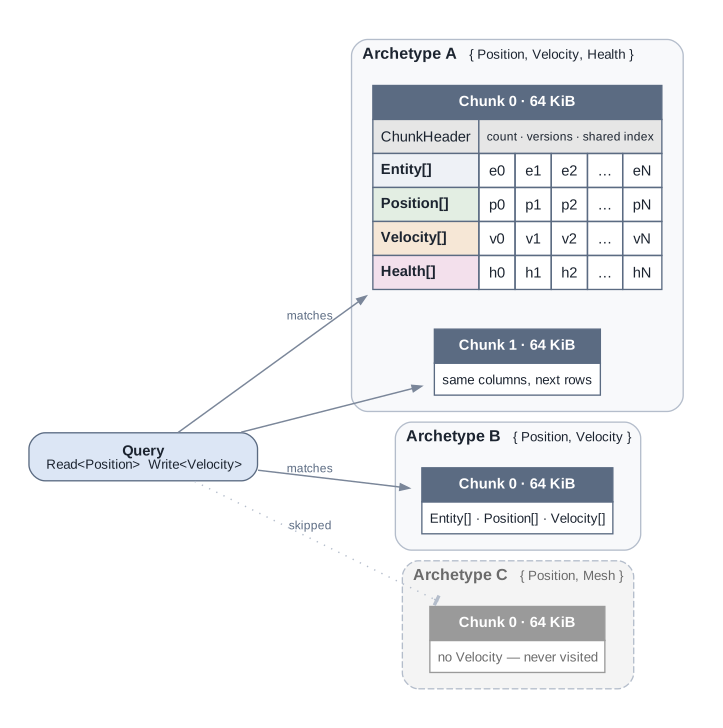
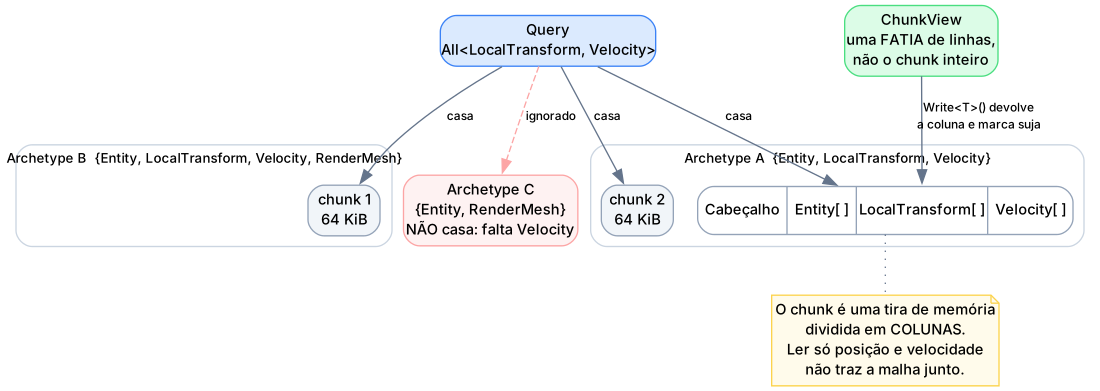
Les entités partageant les mêmes composants vivent dans des archetypes, avec des colonnes SoA contiguës dans des chunks de 64 KiB. Pour deux millions d’entités, 64 KiB nécessitait 1 482 pages contre 5 955 à 16 KiB, avec la même bande passante. Les sparse sets stockent les composants rares sans multiplier les archetypes. Les tables de composants partagés gardent une valeur par configuration distincte, référencée par le chunk.

Chaque SystemDescriptor déclare ses lectures et écritures. L’ordonnanceur en déduit un DAG de dépendances et exécute ensemble les systèmes sans conflit. Avec 32 systèmes, son coût mesuré était de 0,68 µs par frame sur 10 000 entités et de 0,86 µs sur 1 000 000 : il suit les systèmes, pas le nombre d’entités.

Des phases fixes définissent input, simulation, physique, événements, application structurelle, transforms et extraction pour le rendu. Créations, destructions et changements de composants passent par CommandBuffer, appliqué en un point déterministe. Un auditeur d’accès détecte les écritures non déclarées en développement et disparaît à la compilation Shipping. Événements typés, observers et stockage dédié de hiérarchie complètent le modèle ; la propagation par versions évite de recalculer les nœuds immobiles.

Le replay depuis un snapshot a reproduit 120 enregistrements d’audit identiques sur 120 frames, sur la même machine et le même build. C’est la portée vérifiée du déterminisme et la base du Play/Stop de l’éditeur ; le déterminisme entre plateformes n’est pas promis.
struct Entity
{
    uint32_t Index = InvalidEntityIndex;
    uint32_t Generation = 0;
};
static_assert(sizeof(Entity) == 8,
    "Entity is a chunk column; its size is layout.");
Stockage des archetypes en chunks avec colonnes contiguës de composants.
Stockage des archetypes en chunks avec colonnes contiguës de composants. Ouvrir l’original dans un nouvel onglet

Concurrence

Vol de travail sans bloquer la frame

Chaque worker possède un deque Chase-Lev : il empile et dépile sans verrou tandis que les workers inactifs volent à l’autre extrémité. Un worker qui attend un job exécute d’autres tâches sur sa pile courante. Le test avec un seul worker vérifie que les dépendances progressent. Les threads externes au pool attendent passivement ; leur participation créerait deux producteurs pour un deque qui n’en accepte qu’un.

Les jobs ont une affinité AnyWorker, LongRunning ou MainThread. Deux compteurs séparent le travail de la frame du travail long, pour empêcher la compilation de shaders de prolonger l’attente de la frame. Dans la comparaison enregistrée, la frame la plus lente pendant une recompilation est passée de 803 ms à 18,75 ms. Une FrameArena par worker fournit la mémoire temporaire ; ParallelFor sur 1 048 576 éléments a produit le résultat sériel sans allocation sur le heap.

Trois défauts de concurrence sont apparus pendant le développement, dont un uniquement avec la fenêtre de l’éditeur visible. Un watchdog nommant l’étape bloquée a aidé à l’isoler. Le passage du vol par lot au vol par élément a transféré ce coût au thread inactif. Un large graphe de travail réel a mesuré 94,7% d’occupation des workers.

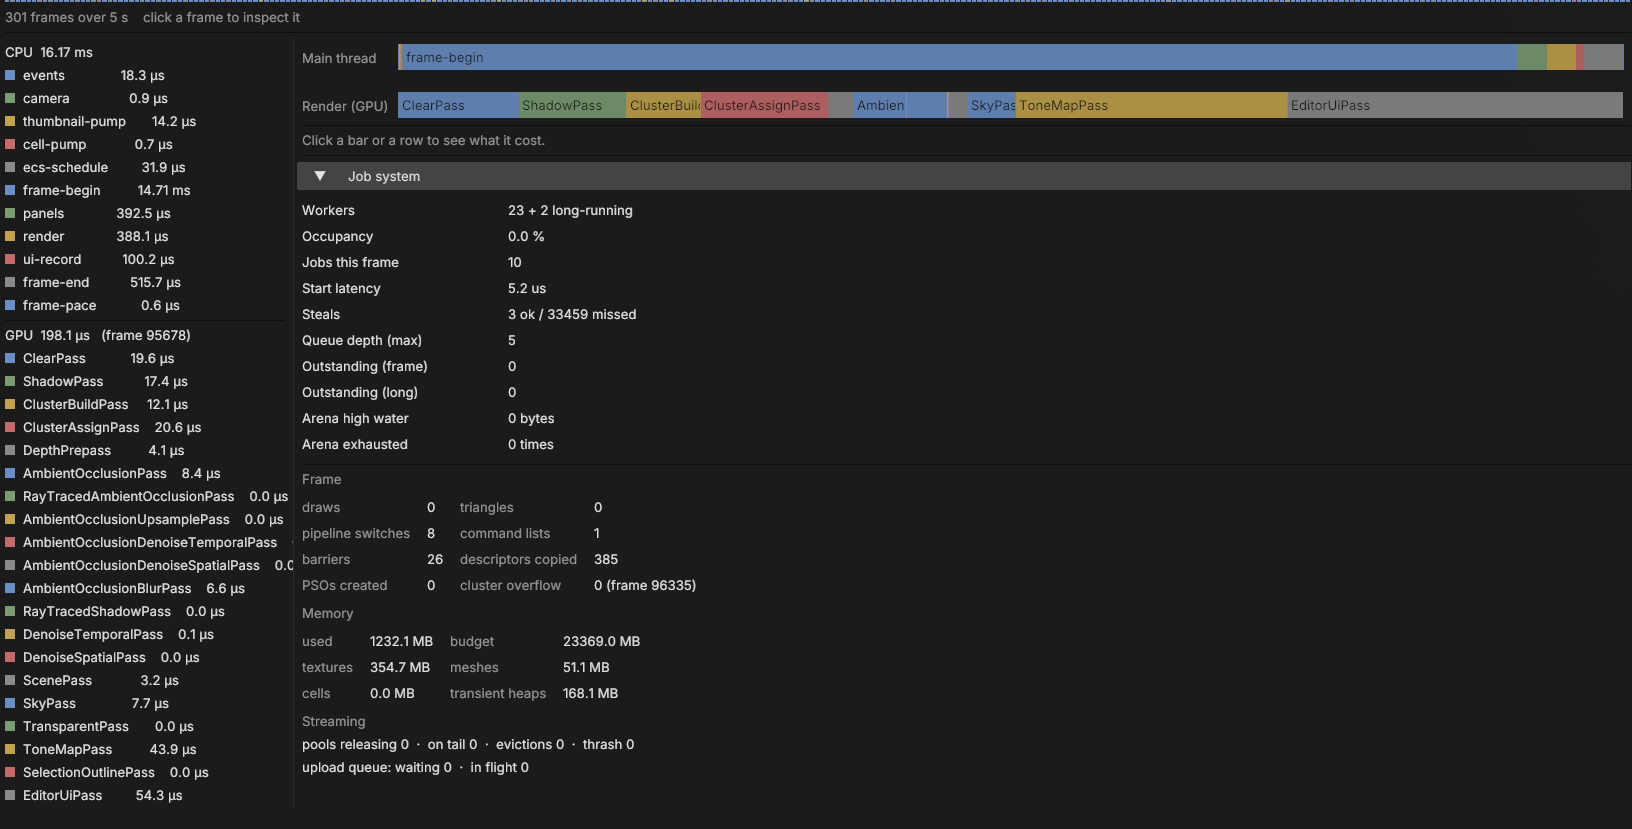
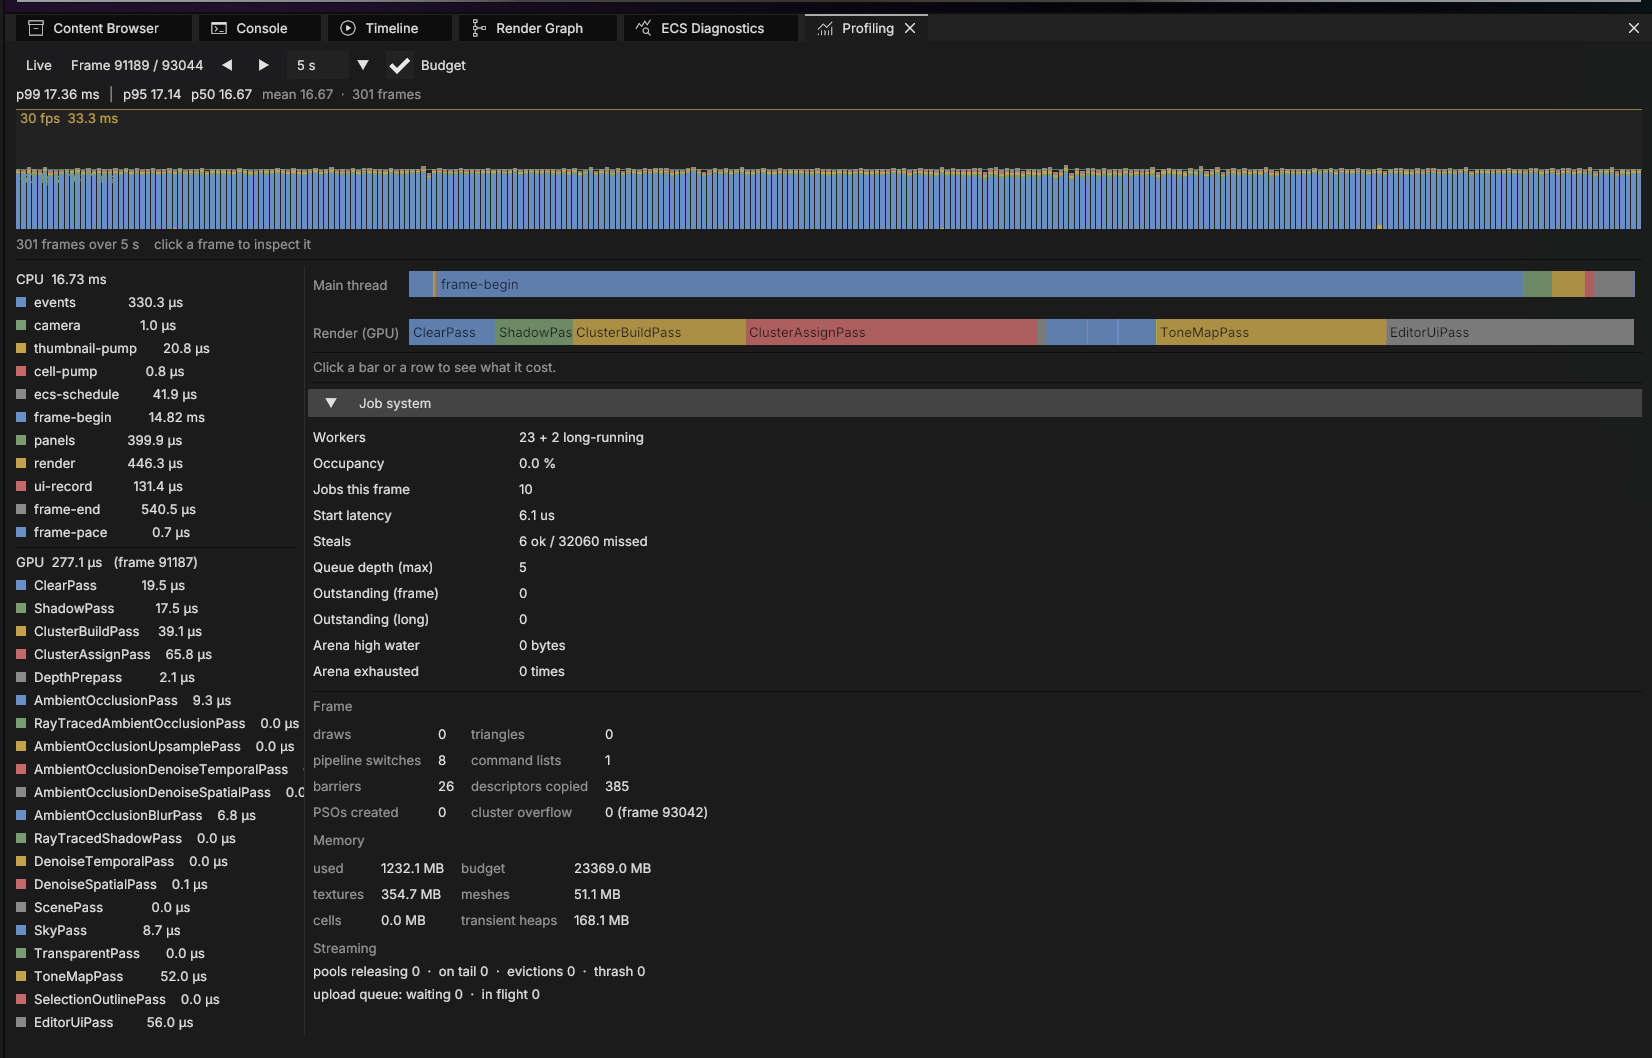
Le cooker utilise le même système : compresser une texture 2048² a pris 311,8 s avec un thread et 9,7 s avec 24. Tracy et une timeline intégrée exposent l’activité CPU/GPU et le travail par worker. Ce sont des mesures précises du projet, pas des garanties générales de débit.

Timeline de profiling avec les jobs par worker.
Timeline de profiling avec les jobs par worker. Ouvrir l’original dans un nouvel onglet

Persistance

Un conteneur, plusieurs chunks

Importer un modèle signifie le préparer pour le runtime. Un projet Tessera stocke les formats du moteur et référence l’original par une racine source nommée ; il ne copie jamais l’original dans le projet et refuse les chemins source absolus. Les données portables du projet restent ainsi séparées des fichiers d’authoring nécessaires à une réimportation.

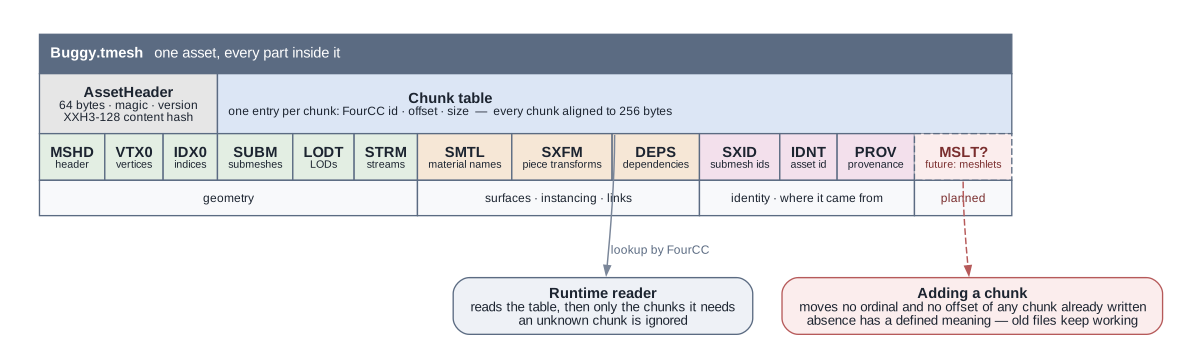
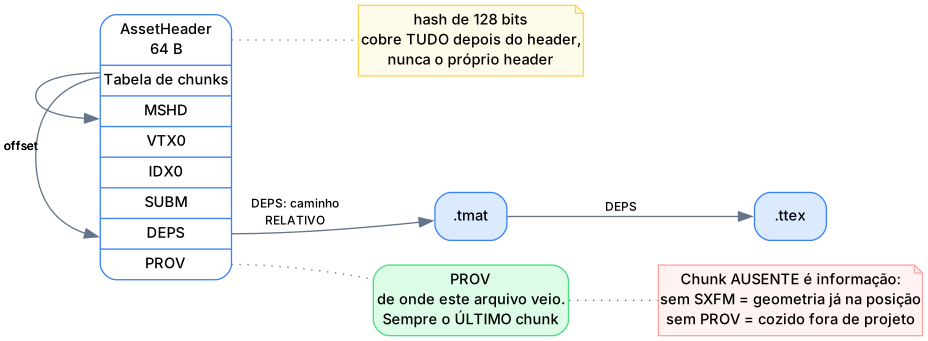
Les formats binaires partagent un header de 64 octets avec magic, version, hash XXH3-128 et emplacement de la table de chunks. Des entrées FourCC localisent les chunks alignés sur 256 octets. Le runtime ne lit que le mip ou LOD nécessaire. PROV enregistre chemin et hash source, version du cooker et options ; scanner un projet inchangé a pris 102 ms contre 316 s pour le repréparer. IDNT conserve l’UUID lors des réimportations.

Un .tmesh contient un asset entier et ses submeshes : l’exemple du buggy transforme 109 maillages en un fichier de 236 submeshes. SXFM conserve les transforms par pièce, permettant de stocker une roue une fois et de la placer quatre fois. Dans la collection mesurée, le stockage est passé de 39,9 MB à 31,0 MB et les draws de 342 à 229.

L’absence des chunks optionnels a une sémantique définie : sans SXFM, le transform est identité. PROV a été ajouté sans changer la version ; SXFM a augmenté la version du mesh tout en laissant les anciens fichiers s’ouvrir et se dessiner. L’évolution du format devient une décision explicite de compatibilité.

FormatResponsabilité
.tmeshAsset de maillage, submeshes et LODs
.ttexTextures et mips compressés BC ; BC6H pour HDRI
.tmatMatériau OpenPBR
.tscn / .tpfb / .tcellNiveau, prefab et cellule de streaming
.tprojDescripteur de projet JSON, hors conteneur binaire
Disposition du mesh préparé et extension meshlets prévue.
Disposition du mesh préparé et extension meshlets prévue. Ouvrir l’original dans un nouvel onglet

Extension prévue

Préparer le chemin vers les mesh shaders

Les mesh shaders ne sont pas implémentés dans le renderer. Le pipeline existant laisse ce chemin ouvert : les slots de la root signature canonique sont visibles à tous les stages, les pipelines utilisent le pipeline state stream, DXC reconnaît ms et as à partir du Shader Model 6.5 et la détection de capacités interroge leur prise en charge par le GPU.

Un test a créé un pipeline de mesh shader avec cette root signature. Cela vérifie la compatibilité, pas un chemin de rendu livré. meshoptimizer est choisi mais pas intégré. Le plan prévoit que le cooker génère les meshlets dans un nouveau chunk .tmesh ; les anciens fichiers conserveront le chemin vertex traditionnel en son absence. Les contrats du conteneur et du pipeline rendent cette extension possible.

Frontière GPU

Le renderer planifie ; le backend exécute

IRenderBackend n’expose aucun type Direct3D. Les ressources utilisent des handles avec génération tels que Handle<TextureTag> et Handle<MeshTag> pour détecter les références à des objets libérés. Render/ construit un plan indépendant du GPU ; RHI/D3D12/ l’exécute. La planification est testable sans device.

Le backend emploie Enhanced Barriers par défaut avec repli legacy, et le bindless Shader Model 6.6 avec repli vers les tables de descripteurs. Sa root signature occupe 13 des 64 DWORDs. Une file de copie séparée gère les uploads ; le streaming avec budget VRAM réduit les mips sous pression au lieu de supprimer la scène. Le hot reload des shaders reconstruit les pipelines affectés.

L’enregistrement multithread est choisi lorsque la charge le justifie. Avec 23 099 draws, le temps CPU de la frame est passé de 207–229 ms à 82–91 ms, soit 2,3–2,8× d’amélioration. La petite frame habituelle conserve volontairement une seule liste de commandes. Les coûts supplémentaires d’ordonnancement et d’enregistrement doivent être justifiés.

Le plan de rendu traverse une interface abstraite avant son exécution par le backend D3D12.
Le plan de rendu traverse une interface abstraite avant son exécution par le backend D3D12. Ouvrir l’original dans un nouvel onglet

Compilation de frame

Un render graph qui produit un plan

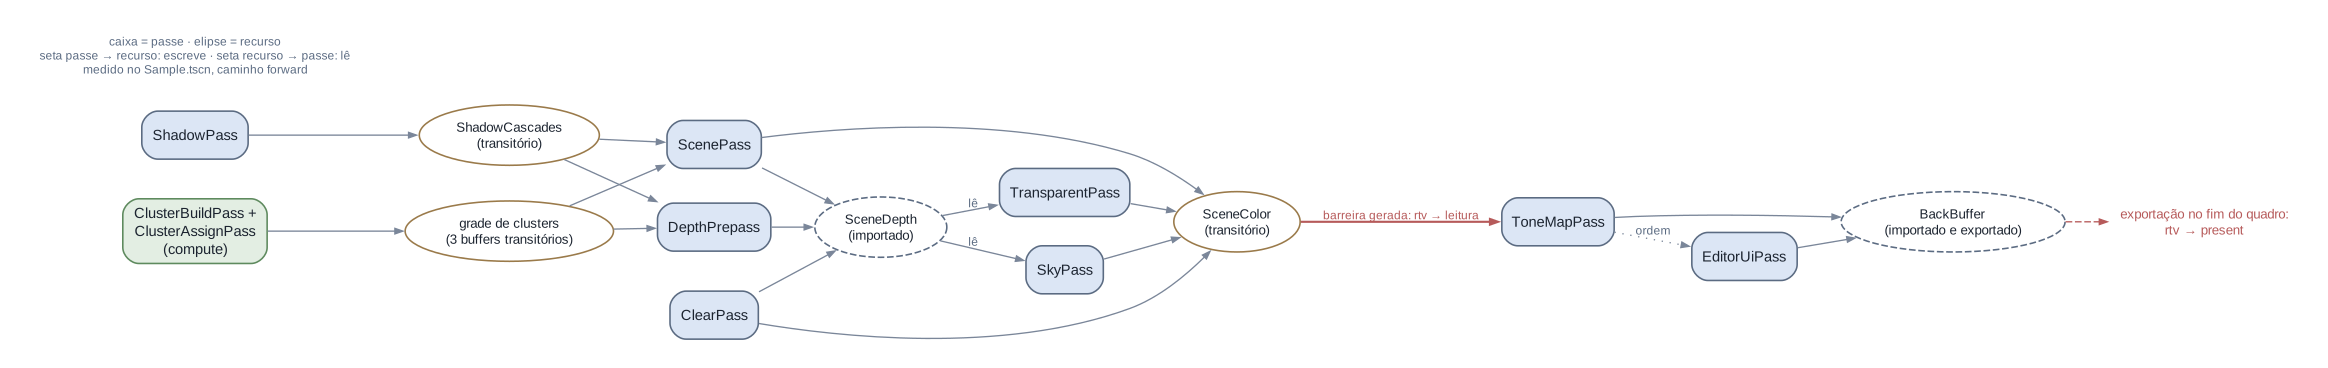
Chaque passe déclare lectures et écritures, types d’accès et stages GPU. Le graphe voit la frame entière et déduit ordre et barrières de ces déclarations. Il n’enregistre jamais de commandes. L’exécuteur D3D12 lit l’ordre d’exécution et les barrières par passe, puis enregistre le travail correspondant.

La compilation construit les dépendances sur le dernier écrivain précédent, rejette les cycles avec un plan vide, retire les producteurs inutilisés, choisit les files, calcule les durées de vie transitoires et génère les barrières lors des changements de rôle des ressources. Ressources exportées et effets de bord déclarés préservent le travail requis ; importer une ressource ne protège pas son producteur de la suppression.

L’ordre d’utilisation diffère de la durée de vie avec compute optionnel : les positions du plan ne décrivent pas les exécutions qui se chevauchent. Le graphe fournit les intervalles ; le propriétaire des heaps décide l’aliasing et demande ses barrières. Mon allocateur regroupe par durée de vie, exigence qui a motivé le rejet de l’approche par taille du D3D12 Memory Allocator évalué. Huit ressources volontairement échelonnées utilisaient 2 688 KB au lieu de 10 752 KB, soit 4,00× de réduction et le minimum pour ce test.

Le graphe forward fourni a été exporté depuis Sample.tscn le 6 octobre 2026. Dans cette configuration enregistrée, 20 passes produisent 15 barrières. Six passes d’occlusion/ray tracing désactivées ouvrent seulement des scopes vides : une passe sans écritures n’est pas un producteur inutilisé et n’est pas automatiquement supprimée. La transition SceneColor avant ToneMapPass est déduite du passage de render target à lecture shader. Les comptes varient avec le chemin de shading et les effets activés.

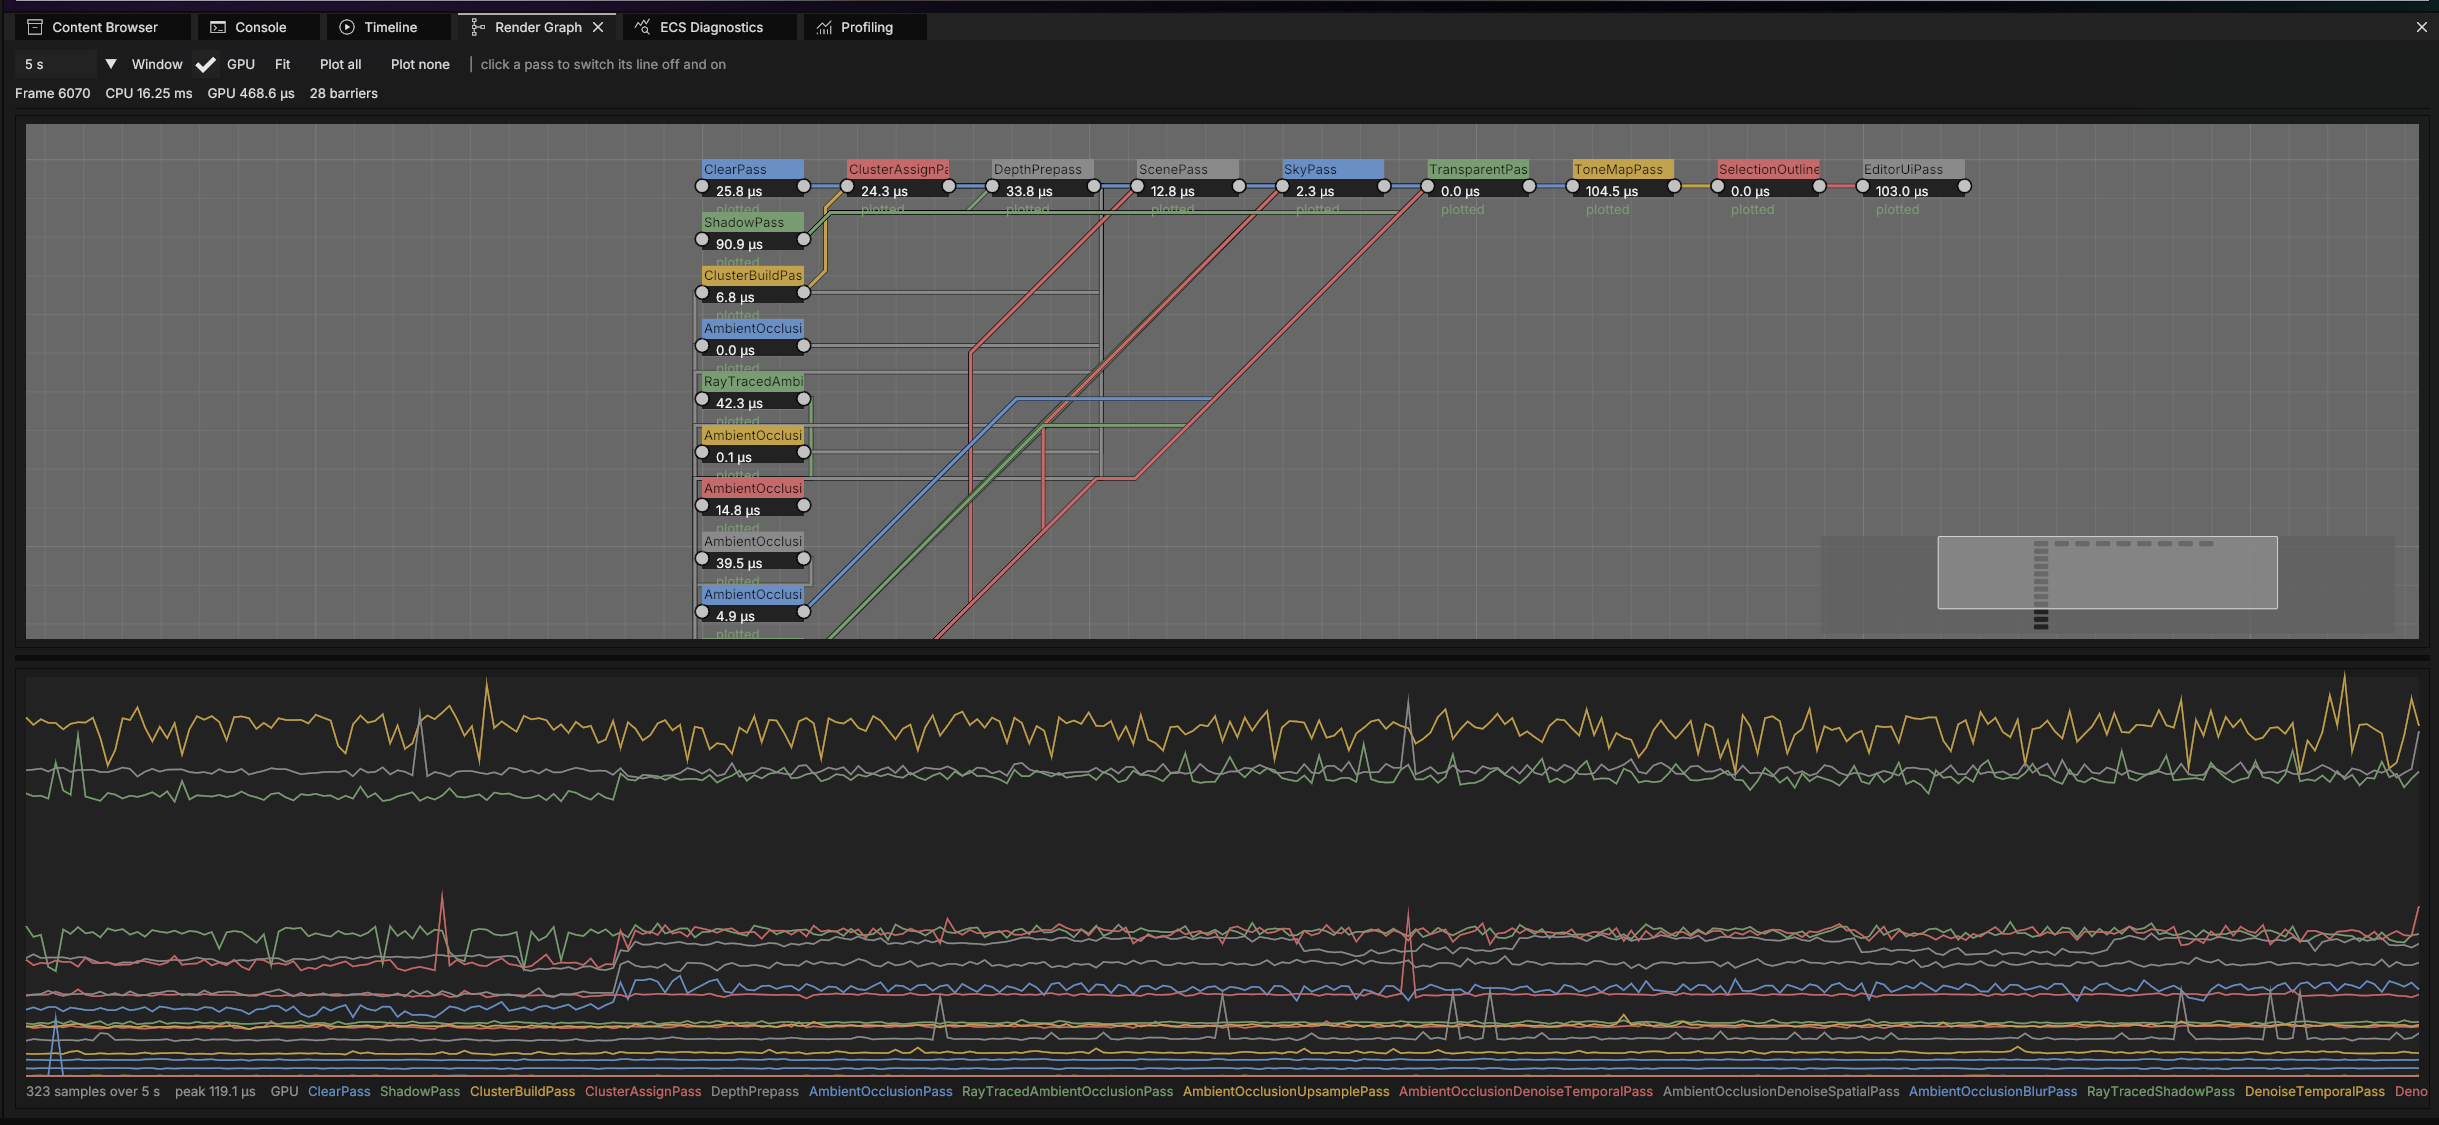
Reset() efface les données de frame en conservant la capacité des vecteurs ; les handles de ressources du graphe expirent alors. L’export Graphviz et le panneau de l’éditeur exposent le plan ; --rendergraph-self-test exécute 242 vérifications sans GPU.

  1. Déclarer

    Importer les ressources existantes avec leur état initial ; créer des transitoires indéfinis ; utiliser AddPass pour déclarer Read, Write ou ReadWrite.

  2. Compiler

    Exporter les états finaux requis, dont present pour le backbuffer. Compile() déduit l’ordre, les durées de vie et la synchronisation.

  3. Exécuter

    Le backend consomme GetExecutionOrder() et GetBarriers() et émet le travail GPU. La planification reste indépendante de Direct3D 12.

Graphe forward exporté depuis Sample.tscn le 6 octobre 2026 ; la transition SceneColor mise en évidence est déduite par le graphe.
Graphe forward exporté depuis Sample.tscn le 6 octobre 2026 ; la transition SceneColor mise en évidence est déduite par le graphe. Ouvrir l’original dans un nouvel onglet

Rendu

Éclairage comparé à une référence

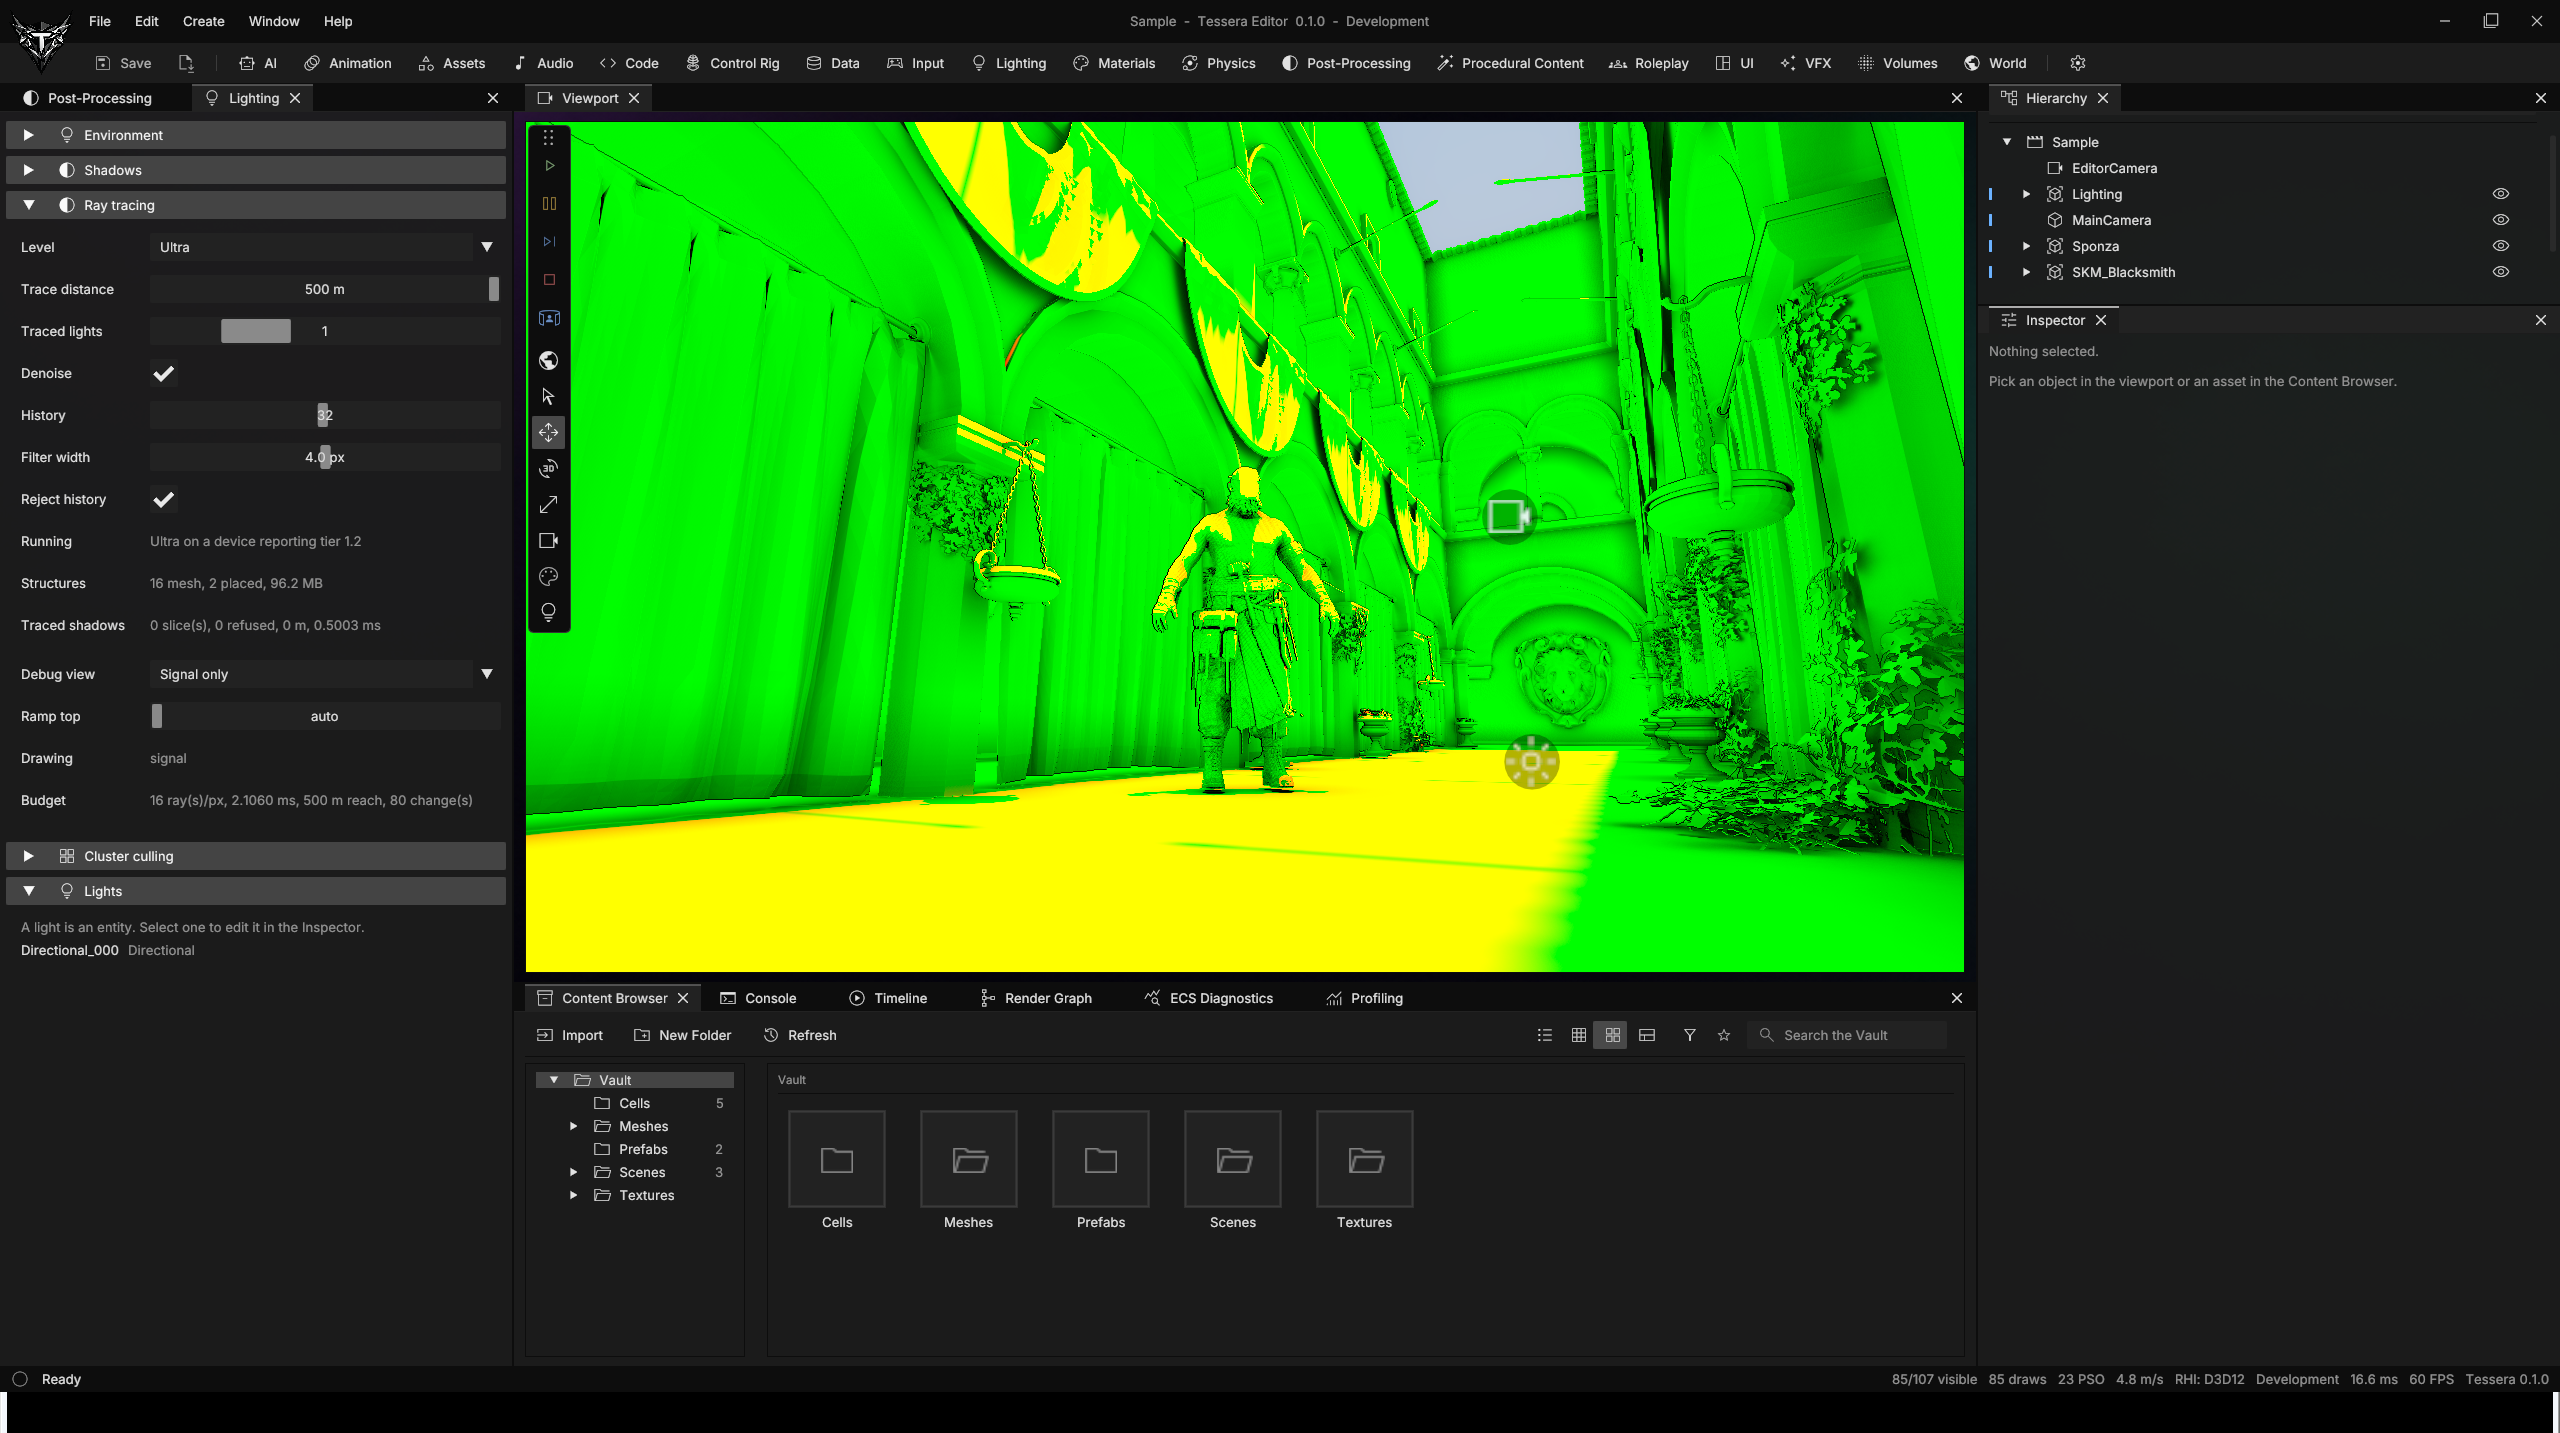
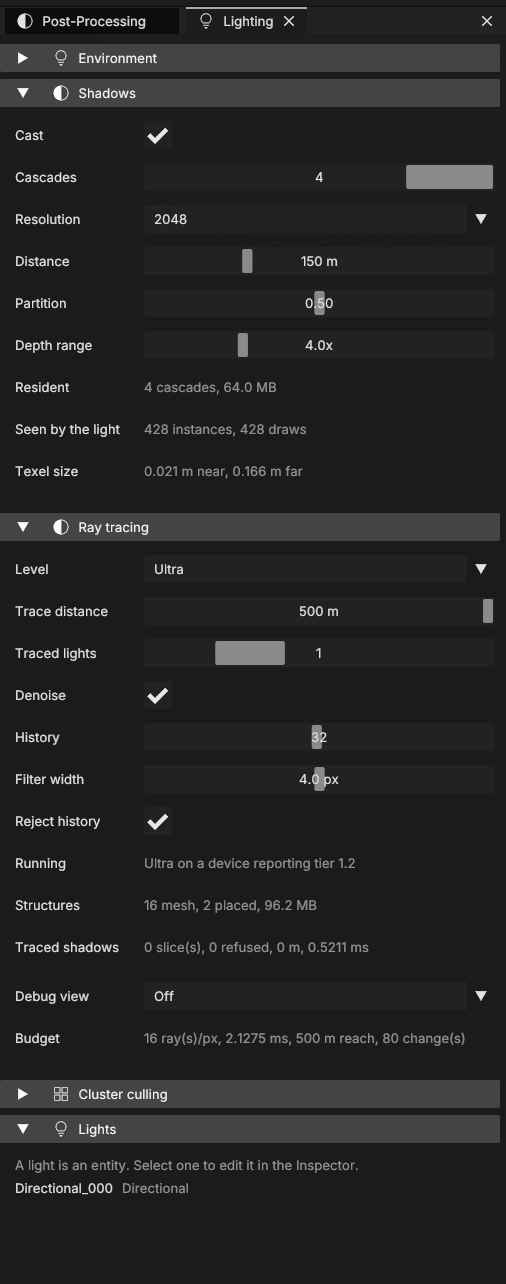
Le renderer implémente coat, anisotropie et fuzz OpenPBR, vérifiés par furnace test ; éclairage basé sur l’image, ciel procédural et HDRI ; ombres en cascades et clustered light culling. Dans le test enregistré, 125× plus de lumières coûtaient 1,39×. Les chemins forward et deferred sont interchangeables, avec SSAO, bloom, exposition automatique par histogramme et transparence.

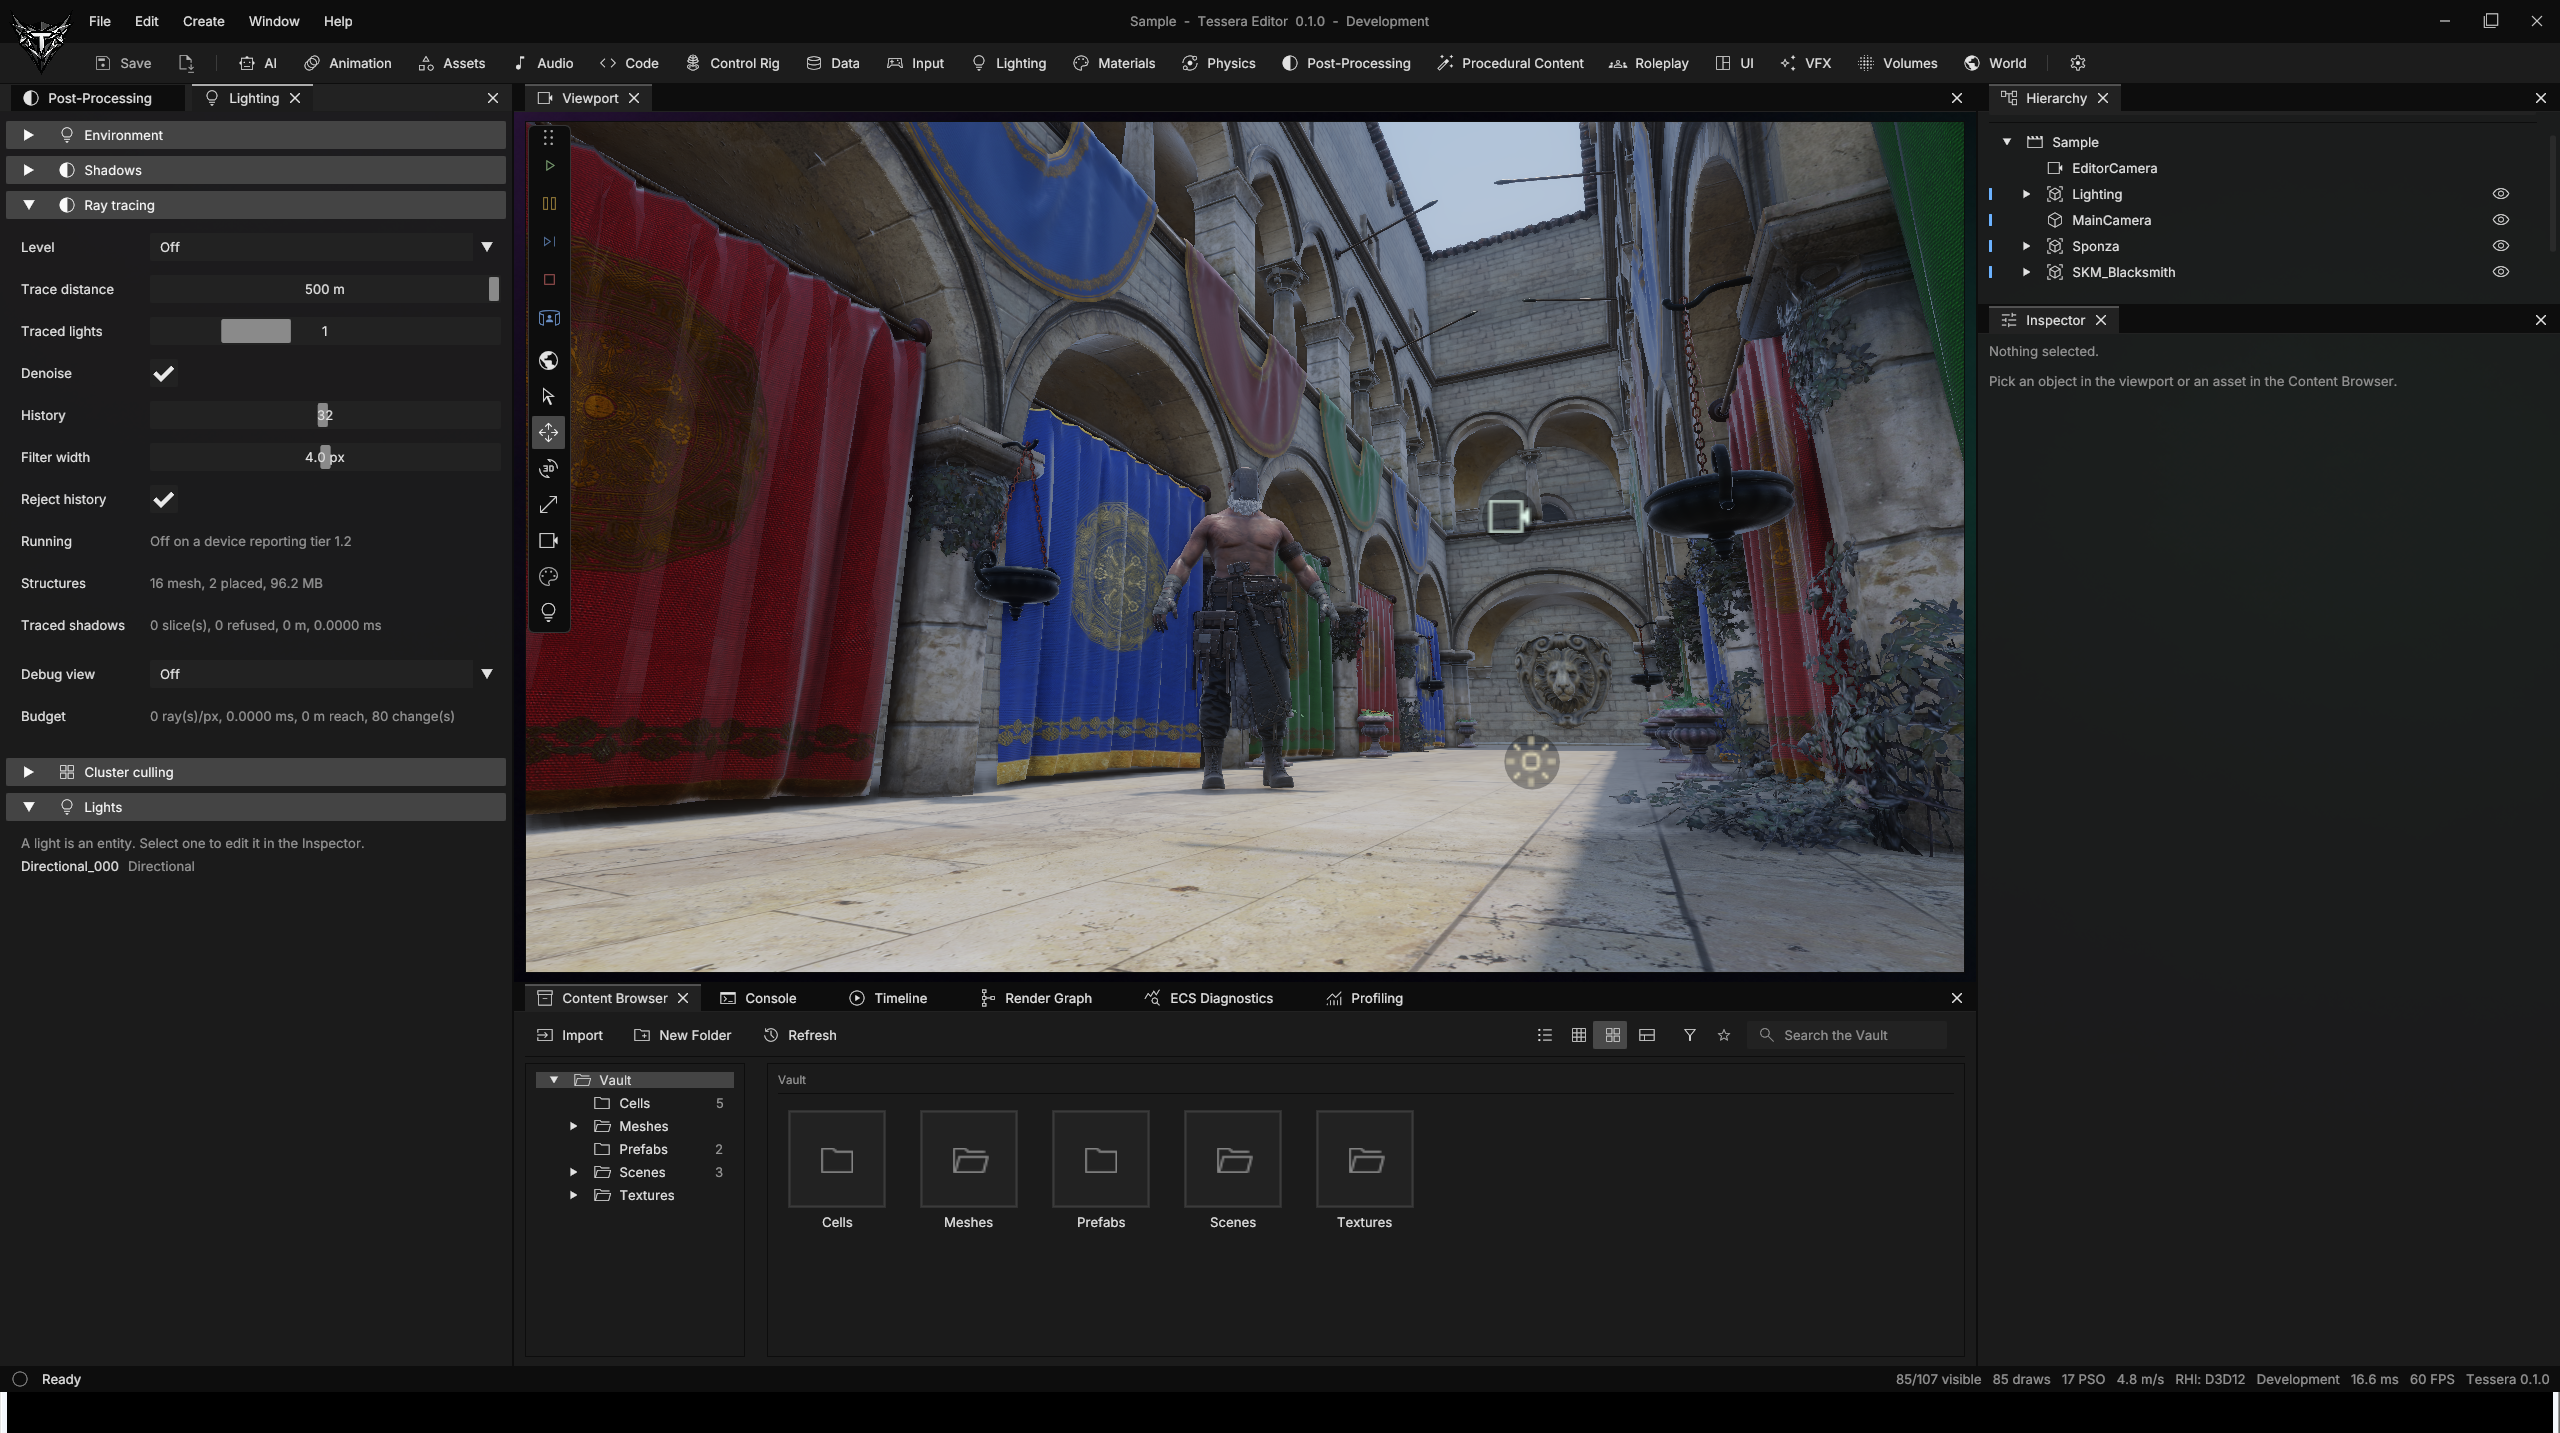
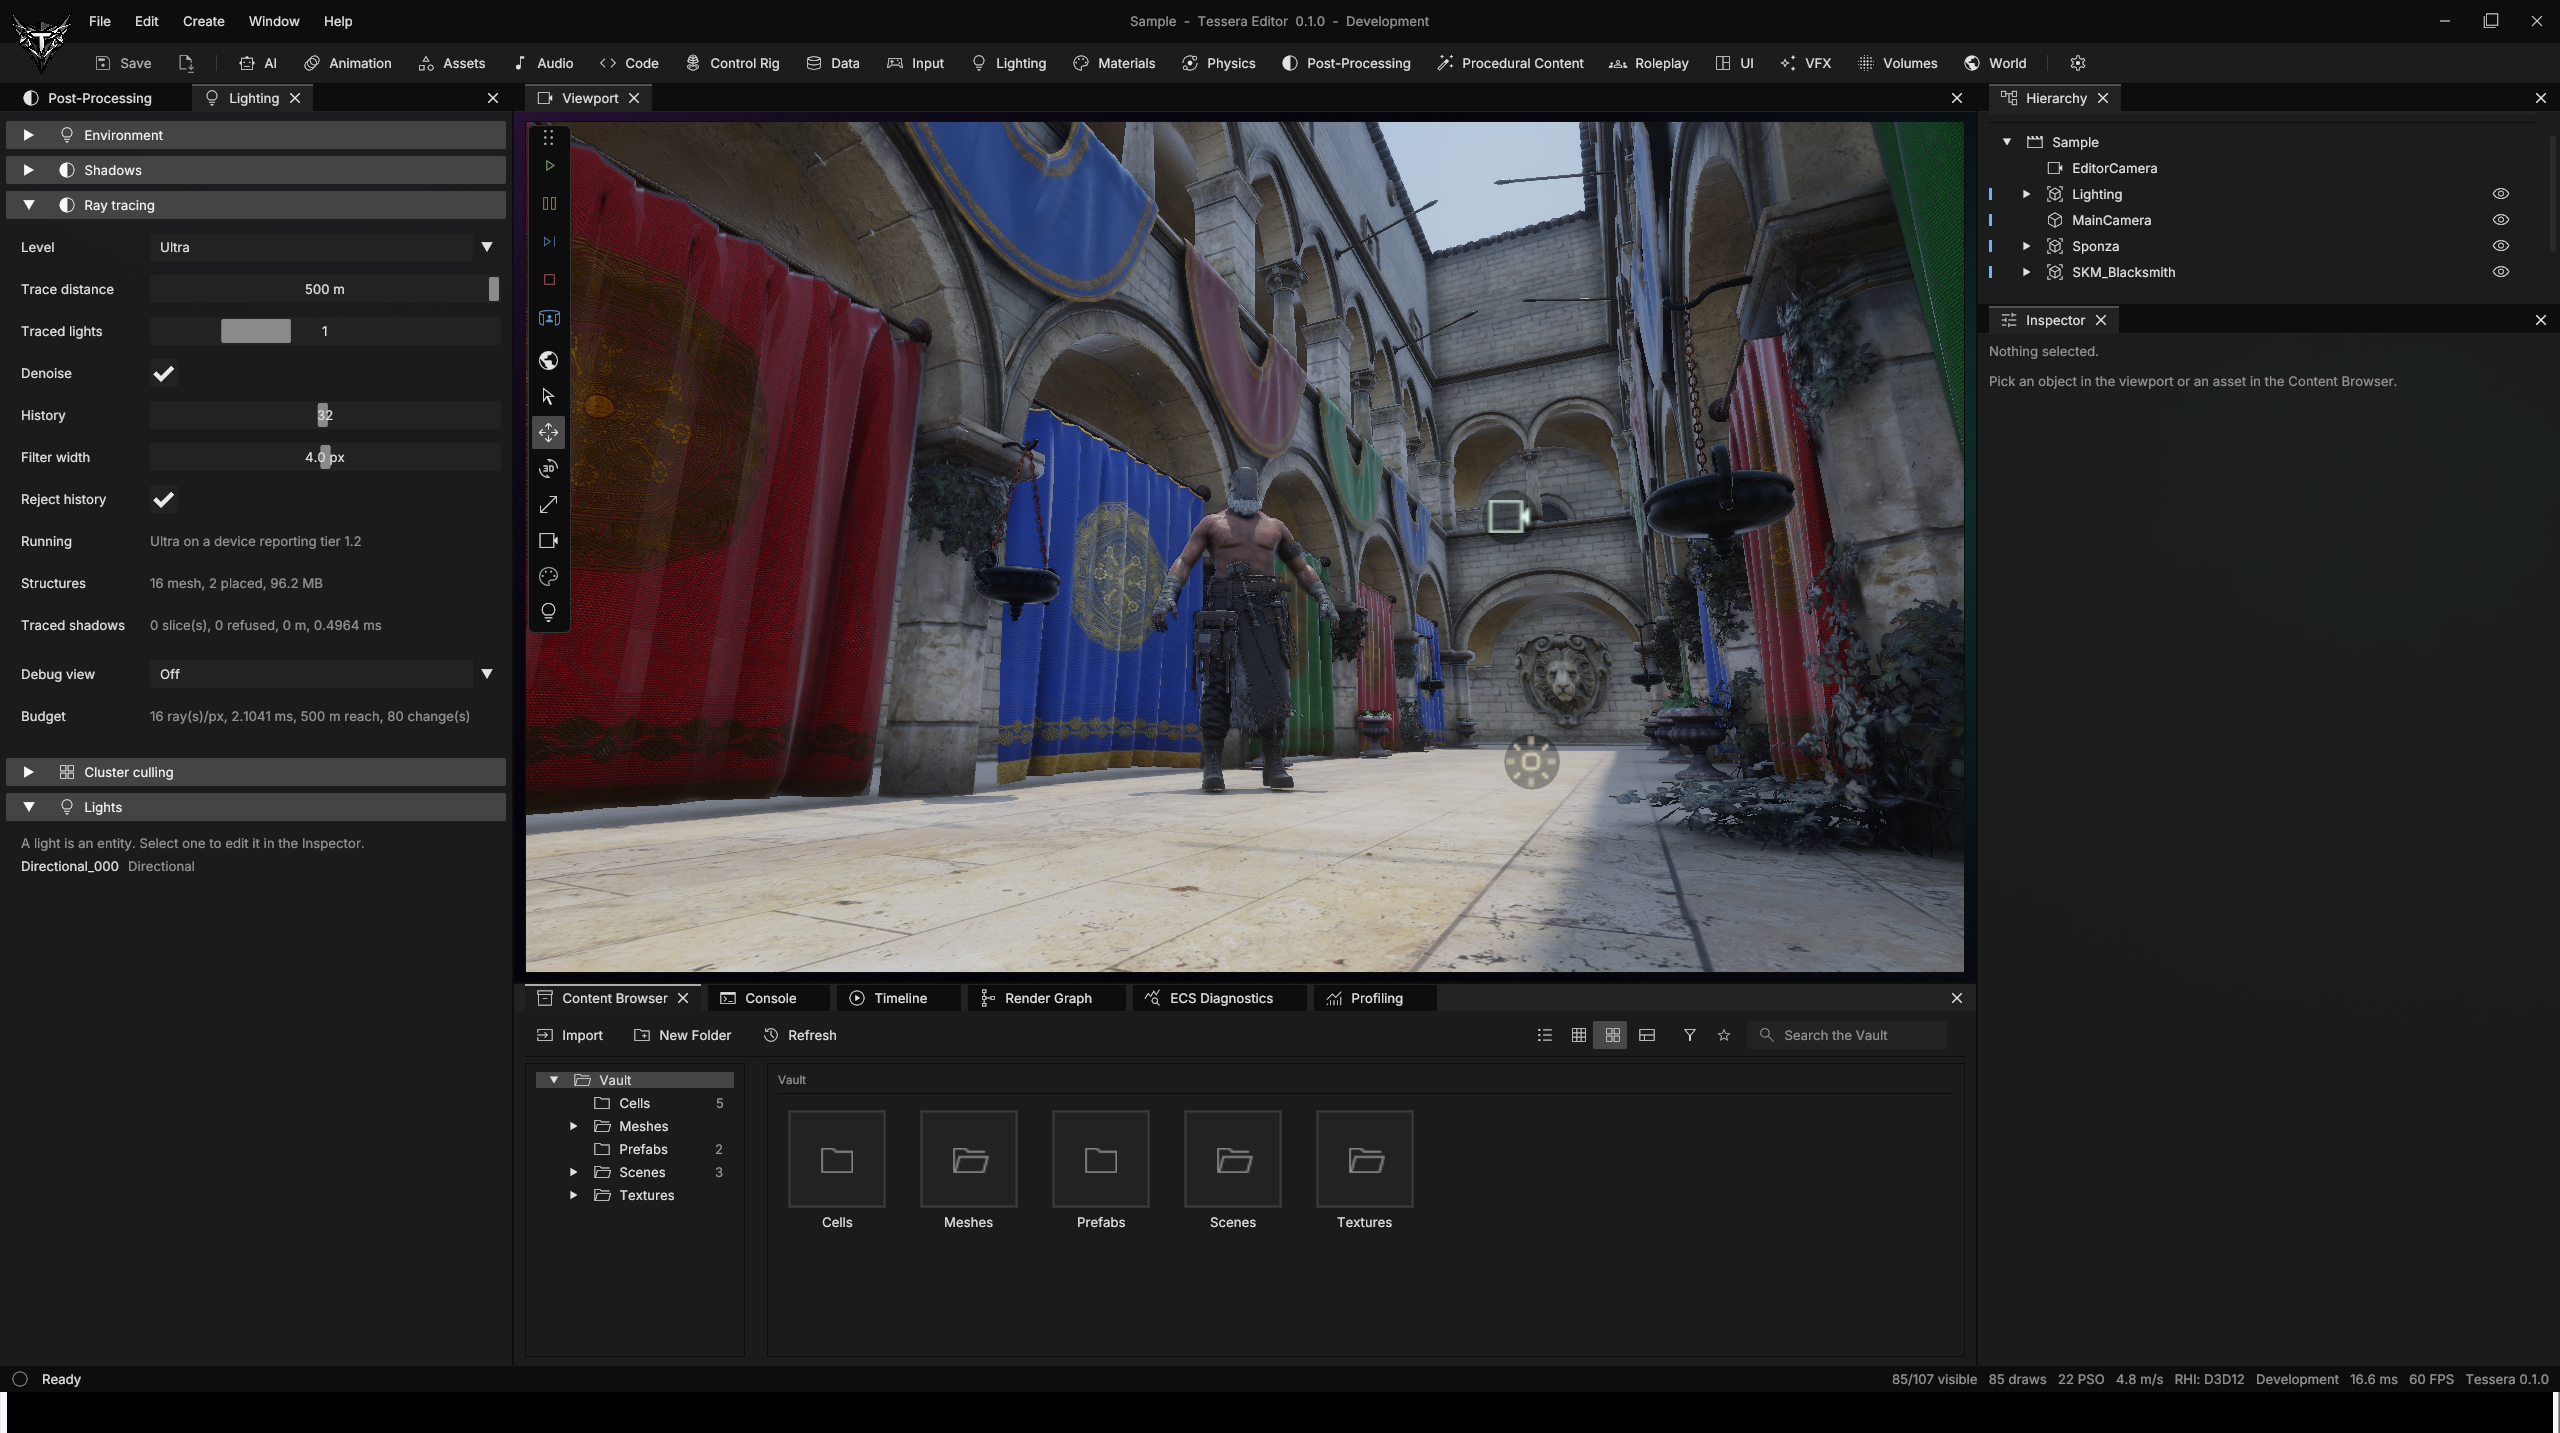
DXR inline avec RayQuery fournit ombres douces, occlusion ambiante et réflexions tracées, ces dernières limitées au deferred. Un denoiser spatio-temporel et des budgets adaptatifs Low/High/Ultra contrôlent les effets temps réel. Un path tracer de référence mesure leur erreur. Les captures montrent la scène d’exemple et les diagnostics ; les compteurs visibles concernent ces captures et ne constituent pas un benchmark pour toutes les scènes.

Scène d’exemple Sponza rendue dans l’éditeur Tessera.
Scène d’exemple Sponza rendue dans l’éditeur Tessera. Ouvrir l’original dans un nouvel onglet

Authoring

L’éditeur utilise les systèmes qu’il expose

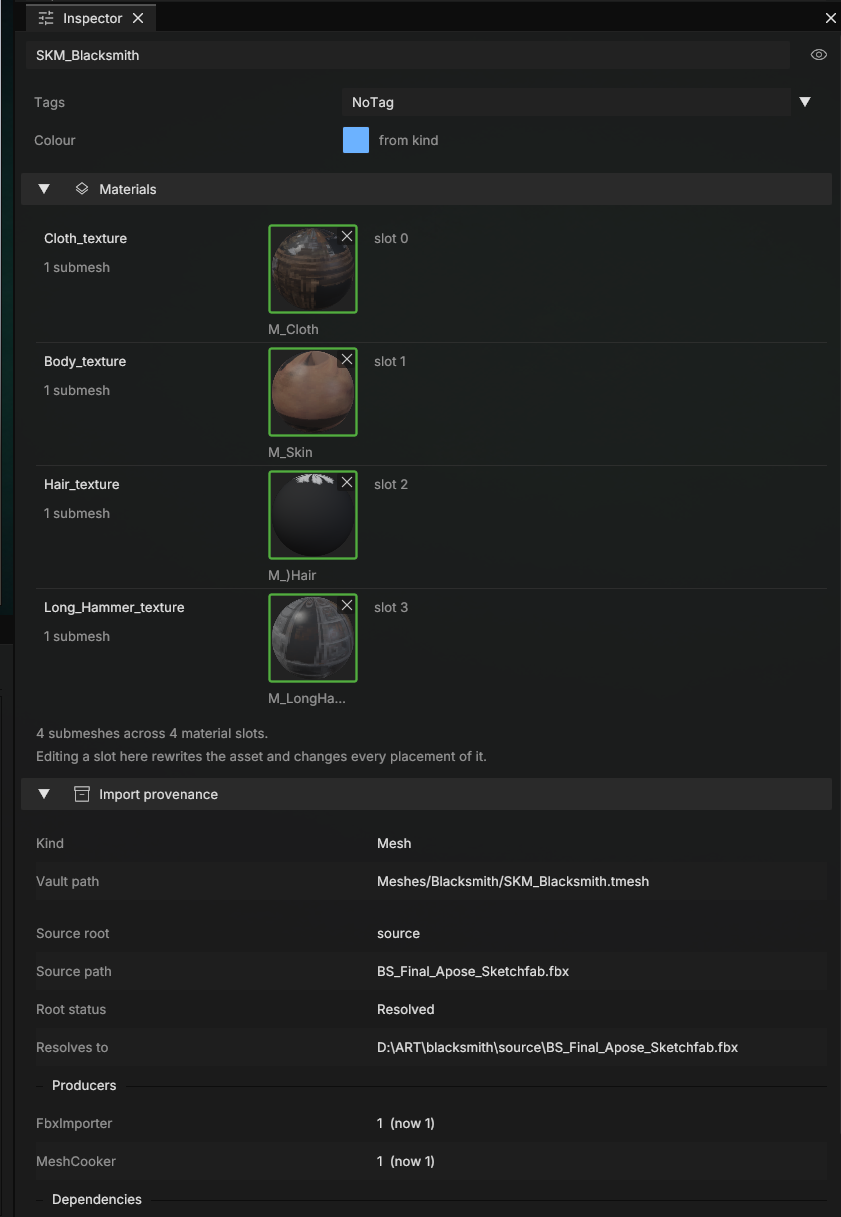
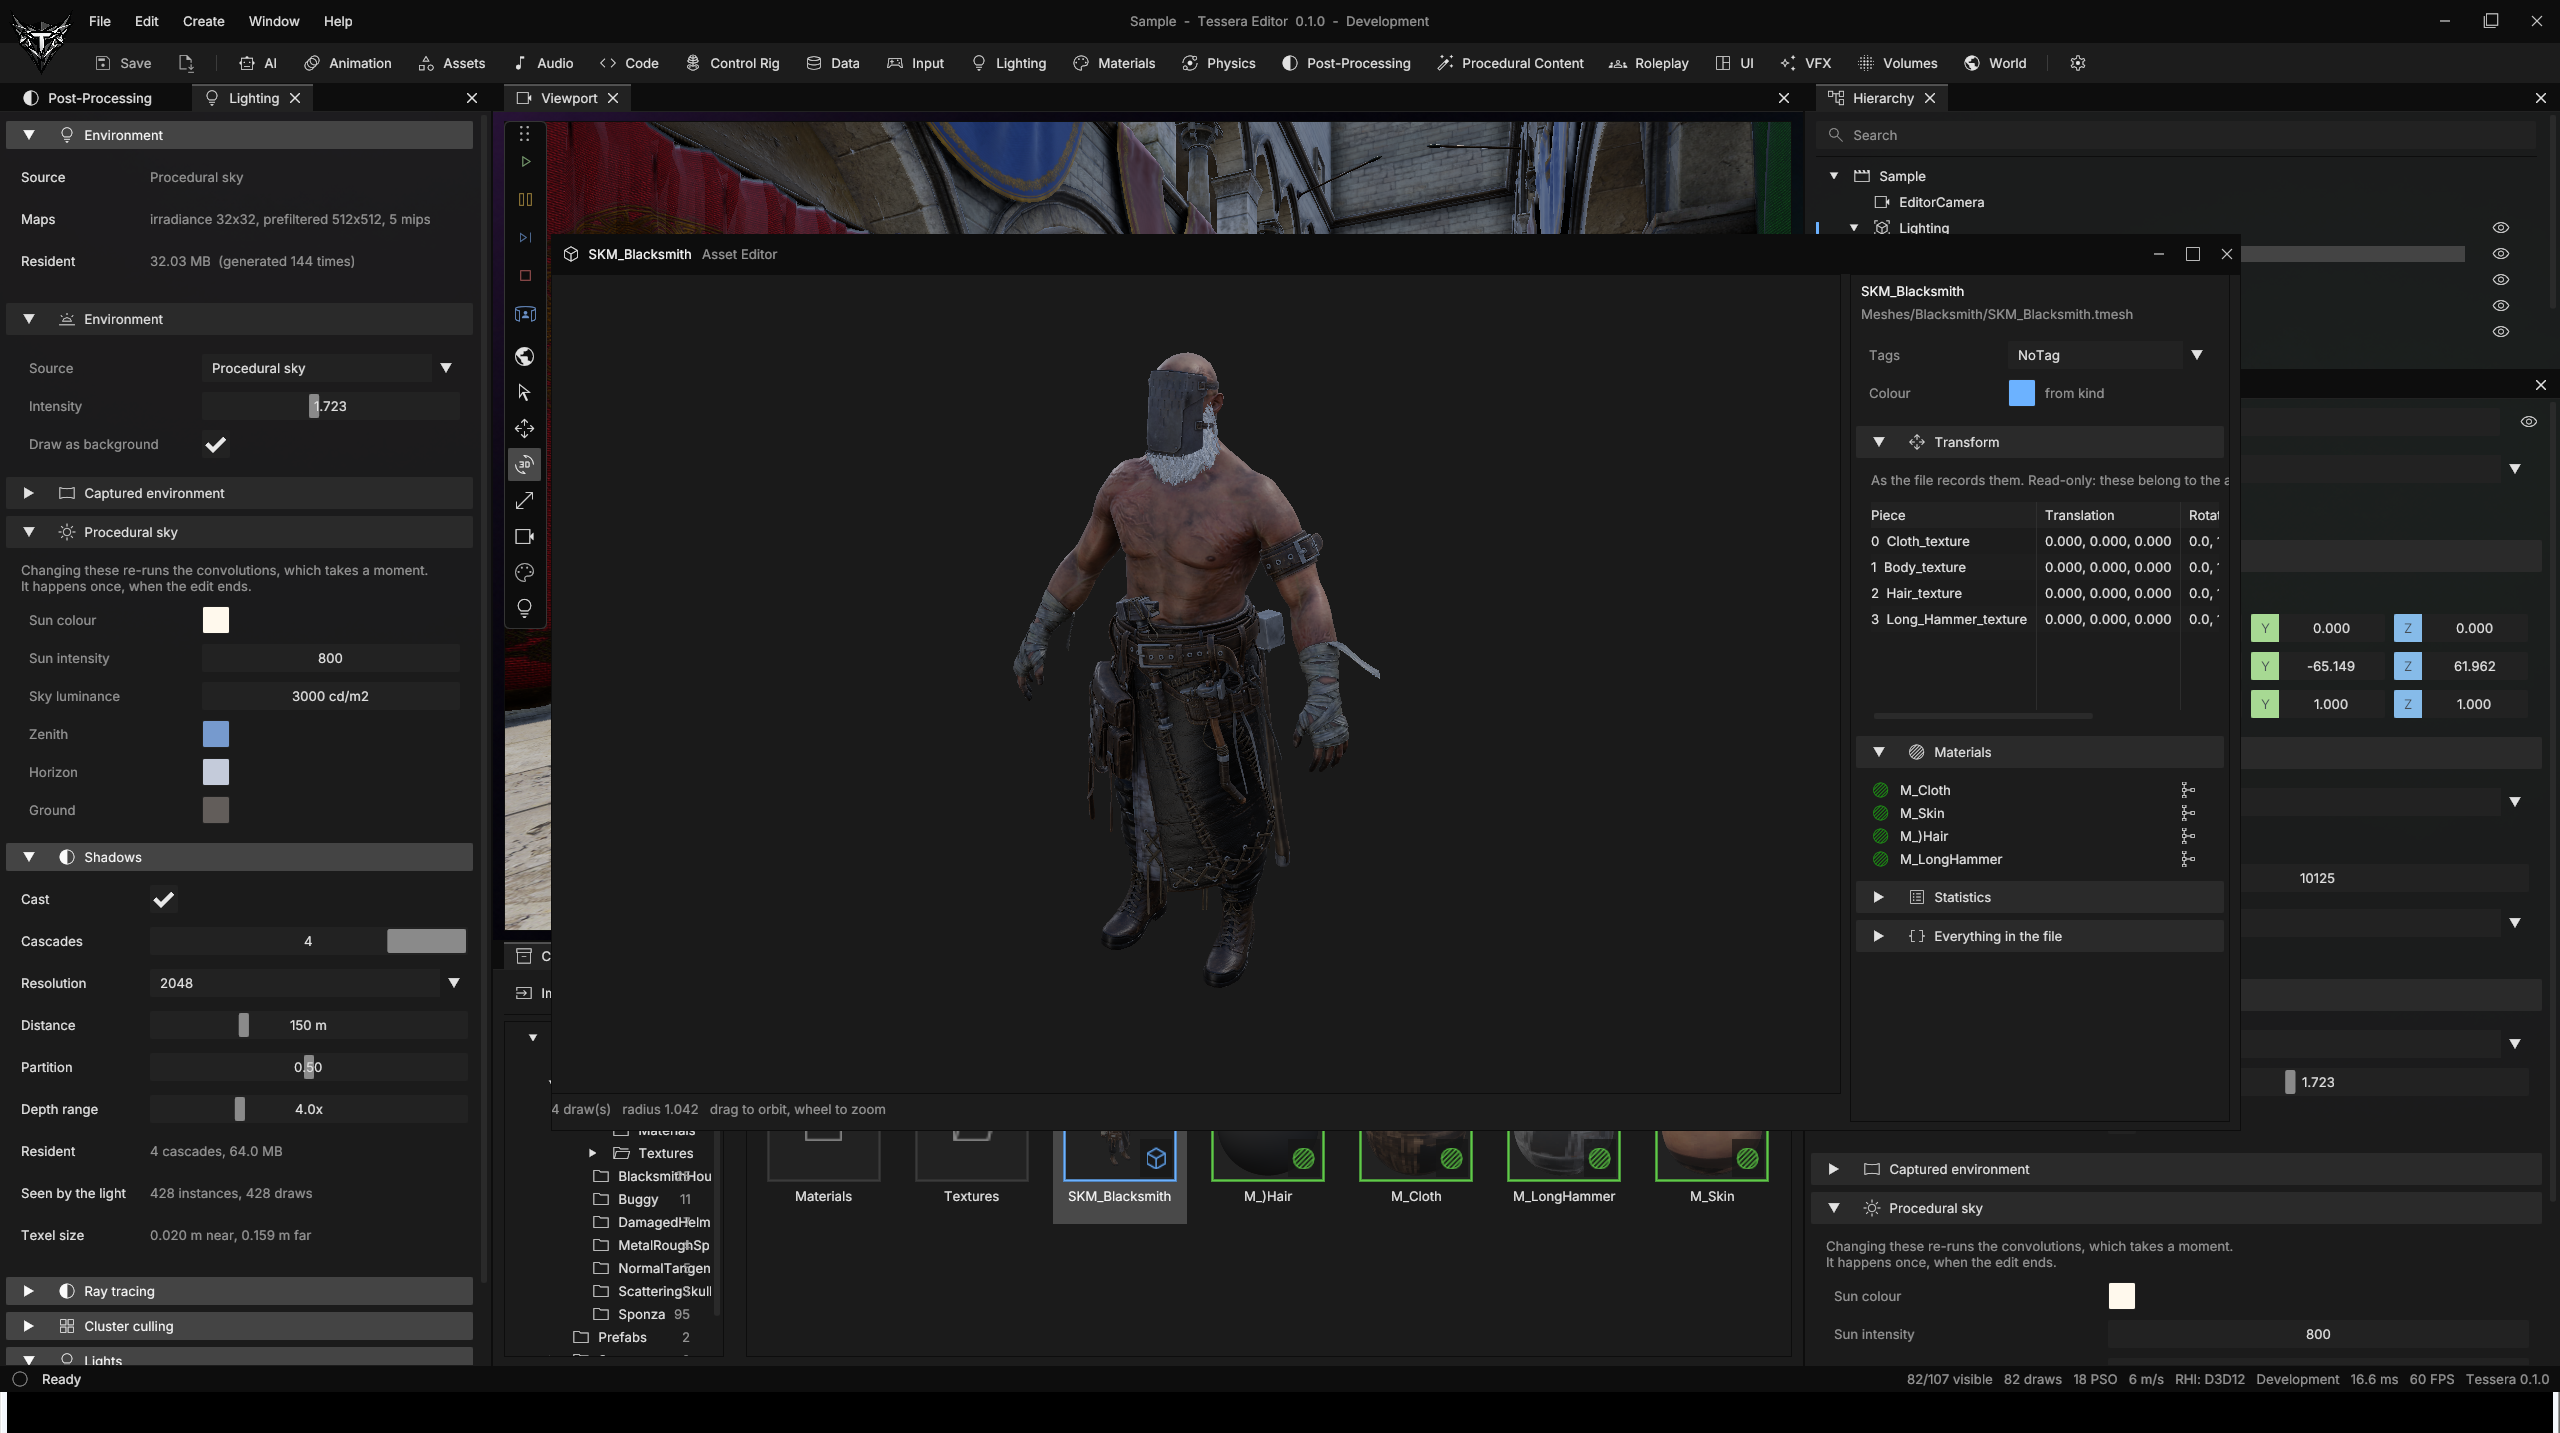
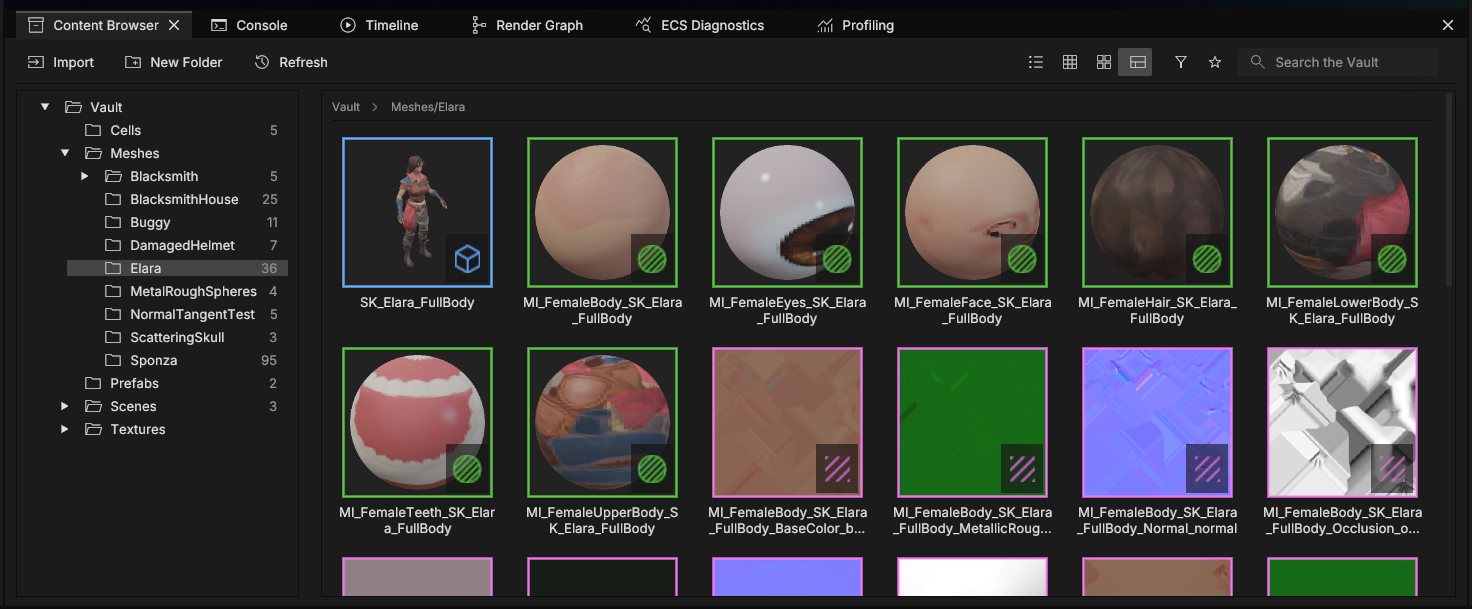
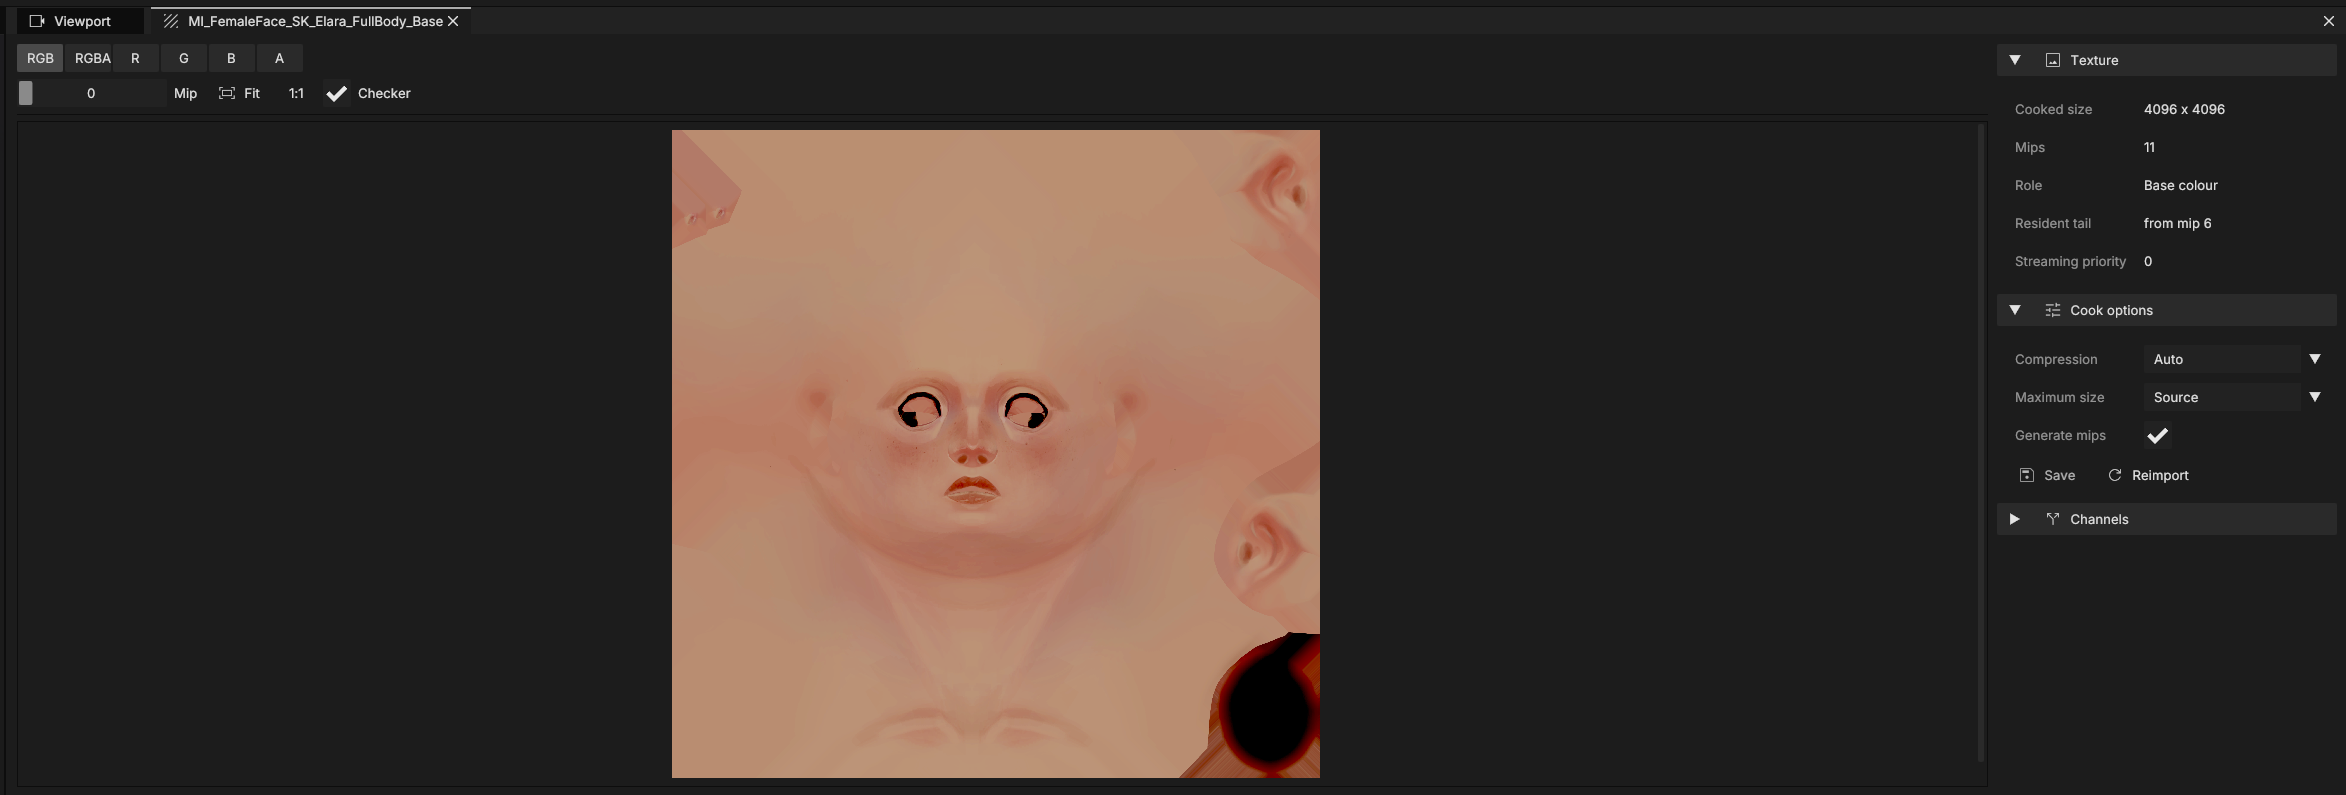
Dear ImGui docking garde l’éditeur en C++, dans le processus du moteur. La Lobby ouvre un projet sans lancer une autre application. Le Content Browser dispose de miniatures rendues, d’un cache disque à invalidation automatique et d’imports en arrière-plan. Les fenêtres mesh/prefab proposent des previews GPU ; l’éditeur de textures isole les canaux et regroupe ORM. Les propriétés d’assets exposent directement les chunks binaires.

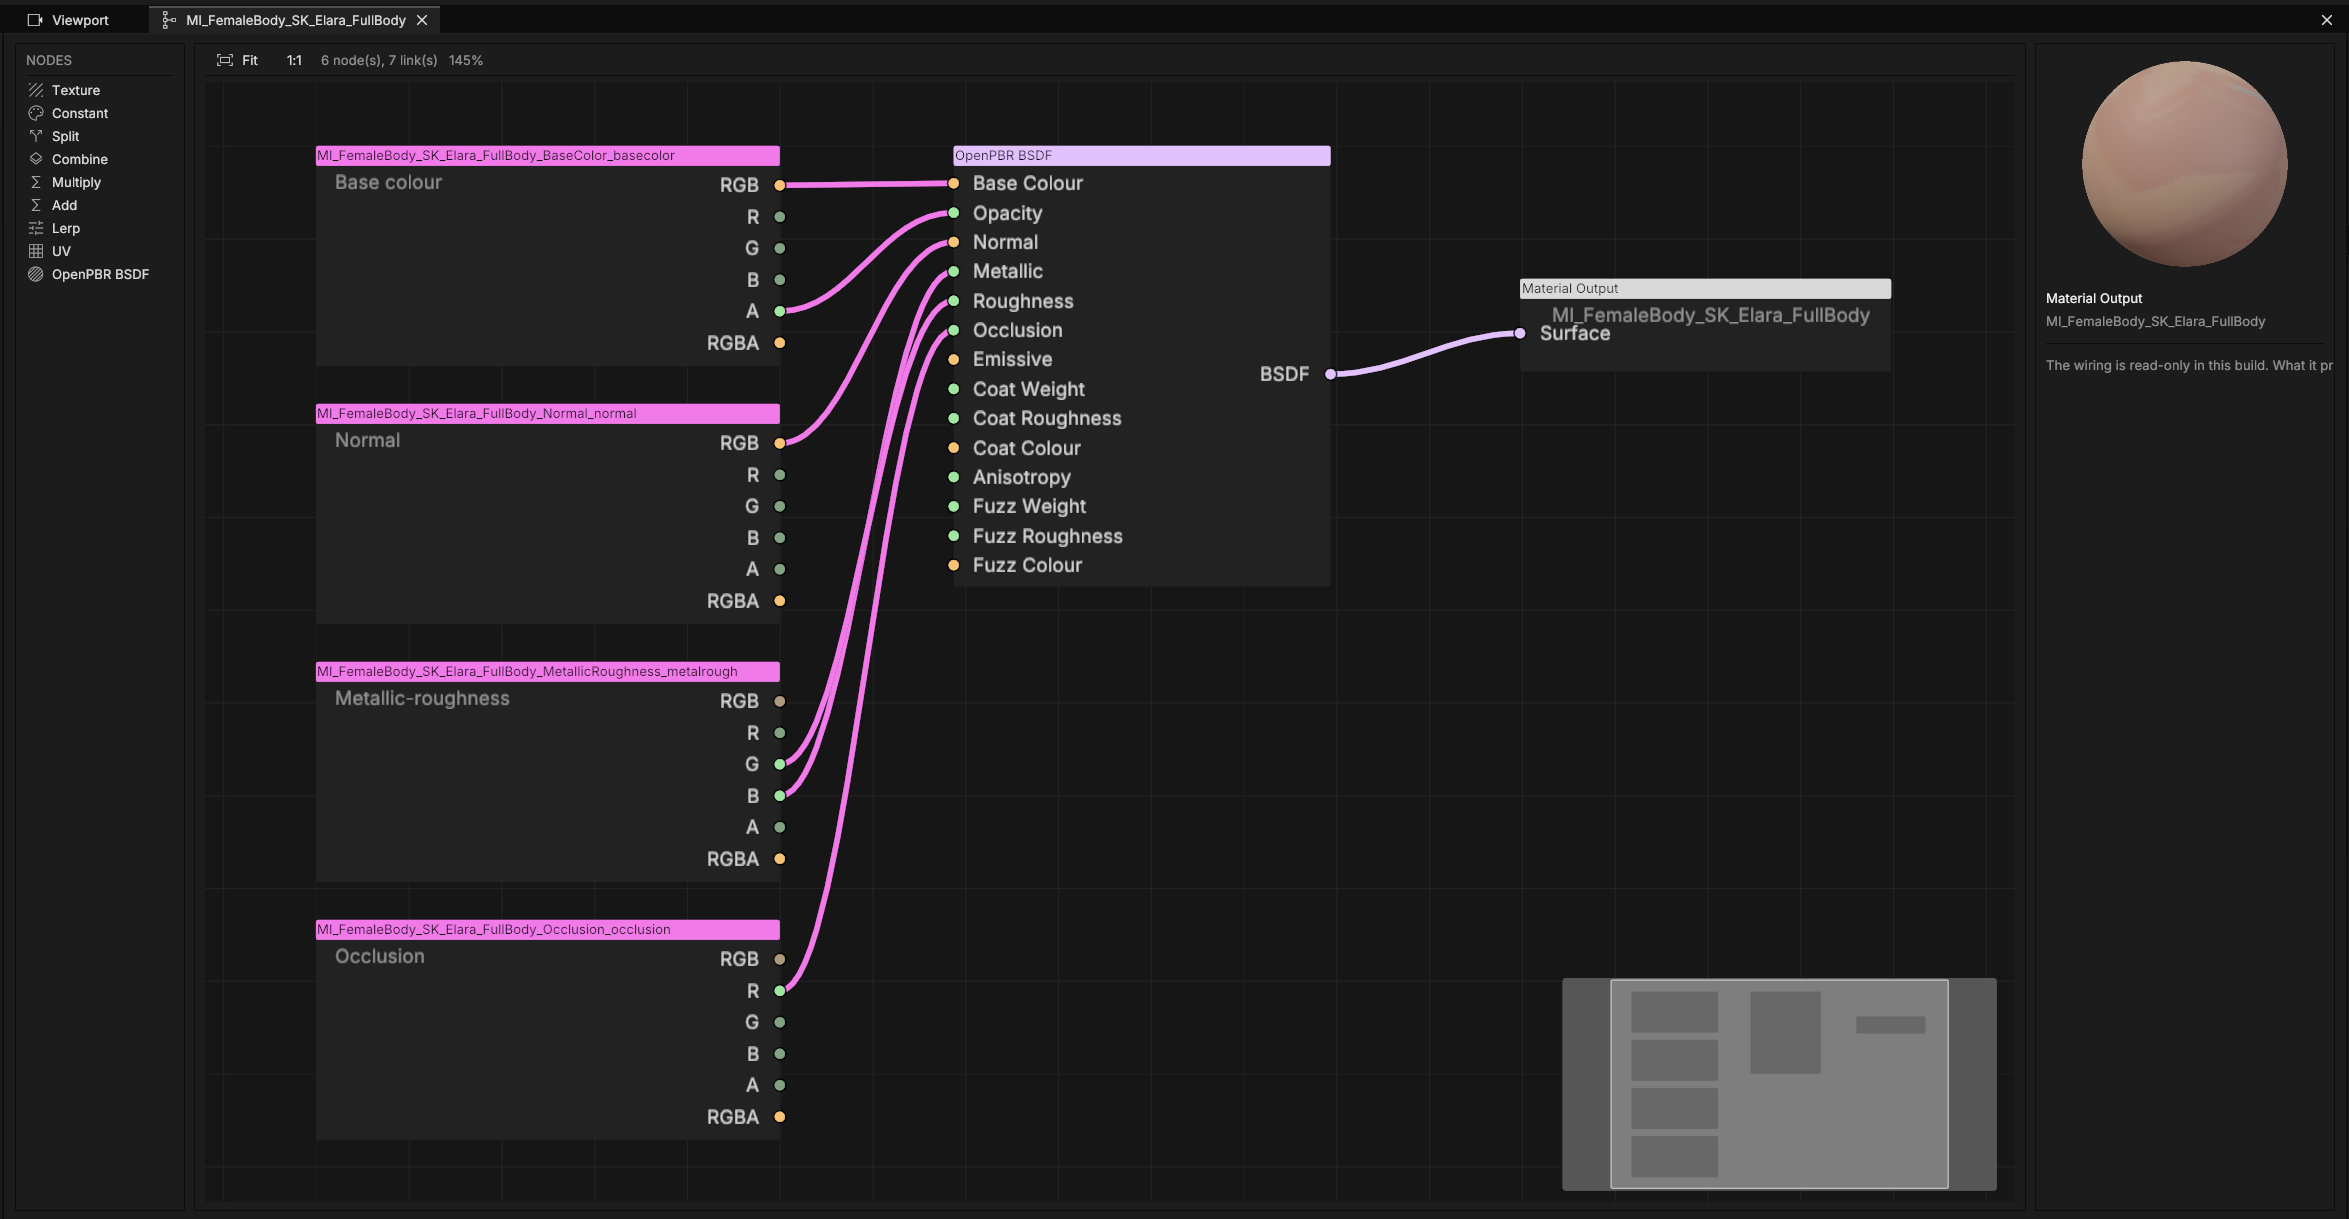
Hierarchy, Inspector, transforms ImGuizmo, undo/redo, prefabs, tags et couleurs d’assets accompagnent l’édition des scènes. Le Material Graph est une vue en lecture seule dérivée du .tmat ; son câblage n’est pas éditable. Les widgets de graphes viennent du GraphEditor d’ImGuizmo.

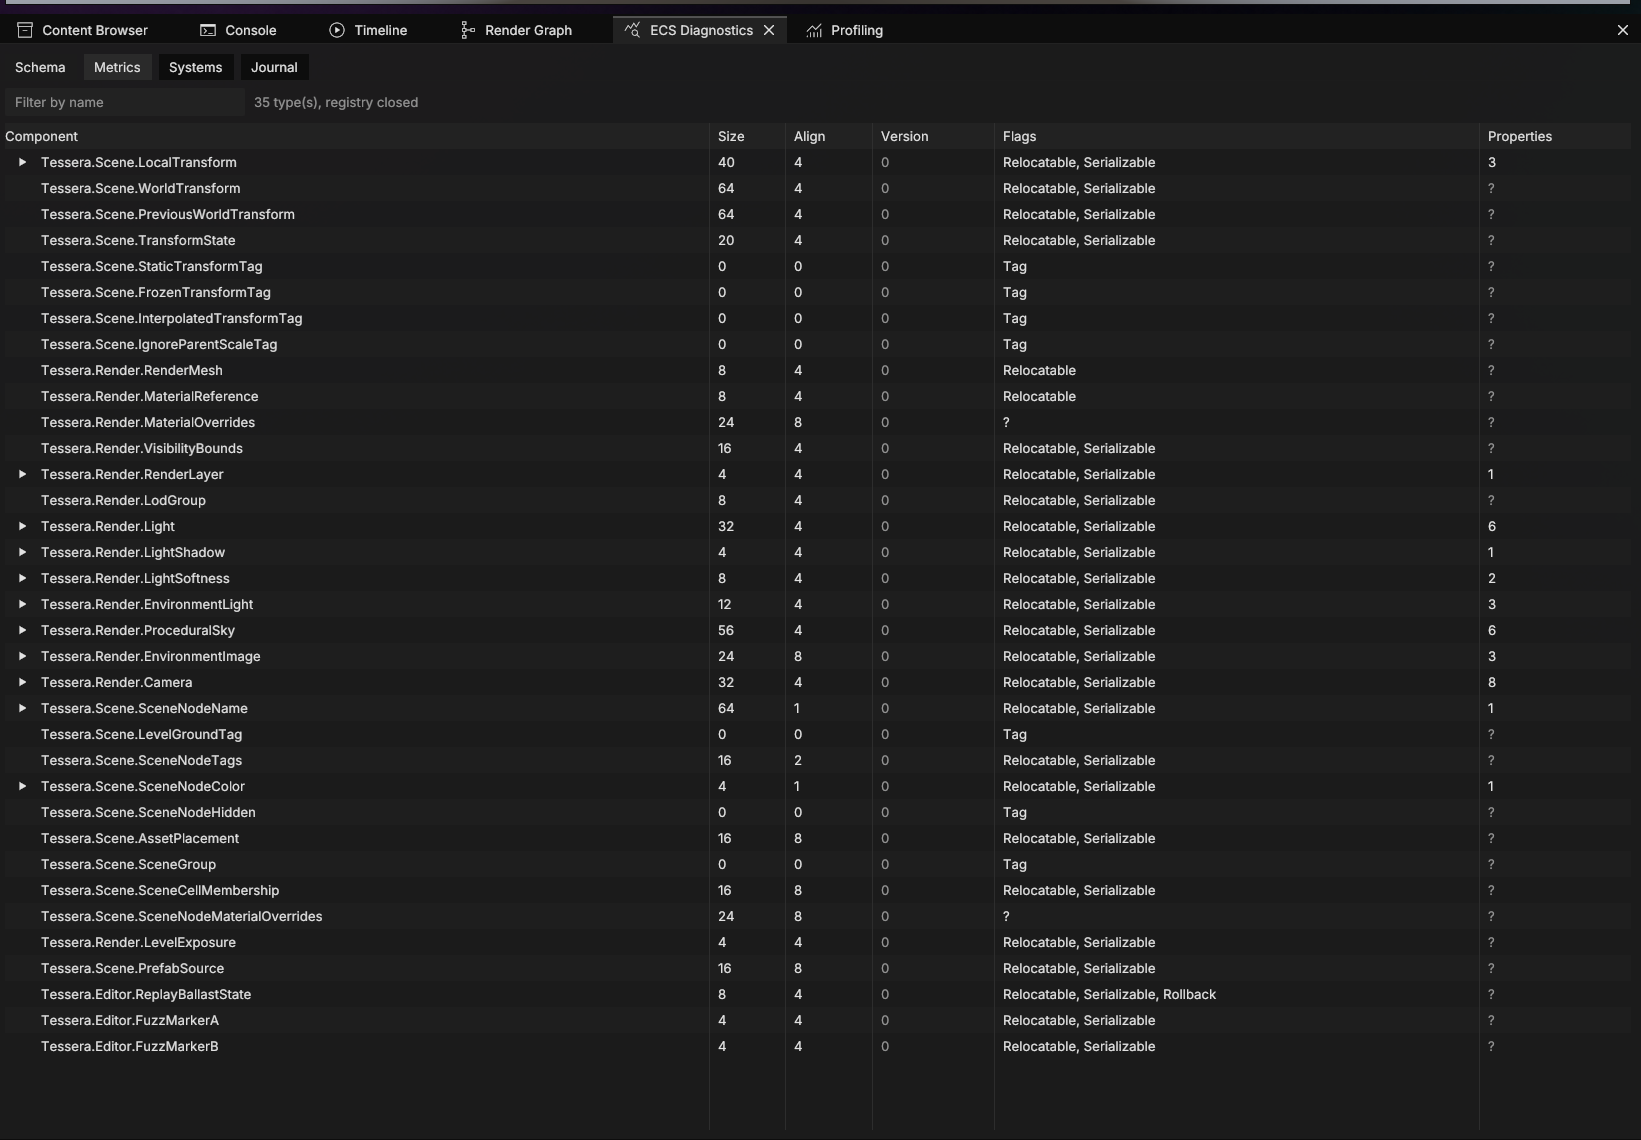
Play, Pause, Stop et Simulate partagent les snapshots : Stop restaure le monde capturé et vérifie un hash identique. Les scènes d’authoring utilisent JSON pour des diffs Git lisibles, puis sont préparées en binaire pour le runtime. Profiling, Render Graph, ECS Diagnostics et Console permettent d’inspecter les systèmes en exécution depuis l’éditeur.

Éditeur d’asset avec preview 3D rendue par le GPU.
Éditeur d’asset avec preview 3D rendue par le GPU. Ouvrir l’original dans un nouvel onglet

Choix techniques

Des dépendances au rôle défini

J’écris les politiques propres au moteur et emploie des bibliothèques pour des problèmes délimités. SDL3 reste derrière IPlatformBackend ; DirectXMath fournit les mathématiques SIMD dans tout le moteur ; DXC compile le HLSL Shader Model 6.x. Dear ImGui et ImGuizmo fournissent les primitives d’interface plutôt qu’une seconde stack d’éditeur managé.

cgltf, ufbx et mon importeur OBJ restent dans le cooker. J’ai choisi ufbx, open source, plutôt que le FBX SDK pour sa triangulation ; mikktspace suit les conventions de tangentes des outils d’art. Parmi les compresseurs évalués, AMD Compressonator offrait la qualité BC7 préférée. stb_image et tinyexr décodent images/HDRI ; xxHash identifie le contenu préparé ; nlohmann/json conserve l’ordre des clés pour des diffs stables.

Tracy fournit les timelines CPU/GPU et WinPixEventRuntime nomme les passes GPU dans PIX. vcpkg fixe les versions avec la baseline du manifeste. Avant d’ajouter une dépendance, je lis la licence de chaque composant à la source officielle, avec une préférence pour l’open source.

Validation

Builds et comparaisons comme contraintes de conception

Je suis revenu à Sharpmake après CMake afin qu’un générateur définisse les builds IDE et ligne de commande. Sharpmake et vcpkg produisent deux solutions en Debug, Development, Profile et Shipping : huit builds locaux, tous avec avertissements traités en erreurs. Les vérifications post-build contrôlent les DLLs runtime et les arborescences de shaders répliquées.

Les tests sans fenêtre comprennent 4 883 vérifications ECS, 242 du render graph et 837 du cooker. Des sondes en ligne de commande exercent les fonctions individuellement ; un harness compare temps et compteurs à une baseline. Les diffs d’images contre la version précédente exigent zéro pixel de scène différent pour les critères d’acceptation des refactorings décrits ici.

Ces nombres viennent des relevés du projet utilisés pour cette étude. Ils documentent la méthode et les scénarios mesurés, sans représenter une nouvelle exécution du dépôt privé par ce site. Build alternatif, audits de replay et comparaisons d’images vérifient des modes de défaillance qu’un build normal réussi ne suffirait pas à révéler.

En cours

Ce qu’il reste à construire

Meshlets et mesh shaders constituent les prochaines étapes du rendu. Jolt Physics, miniaudio, GameNetworkingSockets et Recast & Detour sont choisis, mais pas encore intégrés. Un serveur autoritaire pour 16 joueurs est un objectif ; les snapshots avec portée de réplication et une mesure de précision pour des mondes jusqu’à 200 km² en constituent les bases, mais le réseau n’a pas été commencé.

Upscaling temporel, TAA et motion blur restent à réaliser. L’async compute est implémenté, optionnel et désactivé par défaut ; son gain mesuré d’environ 2% reste sous le seuil de 5% justifiant son activation. L’illumination globale n’est pas implémentée. Windows est la seule plateforme prise en charge.

Certains détails de cycle de vie restent également ouverts : changer de projet dans le même processus accumule encore des maillages en mémoire GPU. Je considère cela comme du travail inachevé. Ces notes rendent visibles l’architecture implémentée et ses limites actuelles.

Contact

Québec, QC, Canada / Ouvert aux opportunités

Je suis ouvert aux possibilités en développement logiciel, en programmation d'outils et de gameplay, ainsi qu'aux postes d'artiste 3D junior. Si mon expérience peut répondre aux besoins de votre équipe, je serai heureux d'échanger avec vous sur mes réseaux sociaux.