Proyecto personal / Arquitectura de engine

Tessera Engine

Un motor de juegos construido con responsabilidades explícitas y decisiones medidas.

Tessera es el motor de juegos y editor para Windows que estoy desarrollando en C++20, con Direct3D 12 y Agility SDK. Escribo el ECS, el sistema de jobs, la pipeline de assets y el renderizador. Este estudio explica cómo se conectan, por qué definí sus límites y cómo verifico su funcionamiento.

Las decisiones se miden, no se suponen. Tests por subsistema, sondas de línea de comandos, referencias de benchmark y comparaciones de imágenes acompañan la implementación. El repositorio es privado; la arquitectura, las capturas y las mediciones documentadas aquí presentan una visión técnica del trabajo en curso.

  • C++20
  • Windows
  • Direct3D 12
  • Dear ImGui
  • Sharpmake
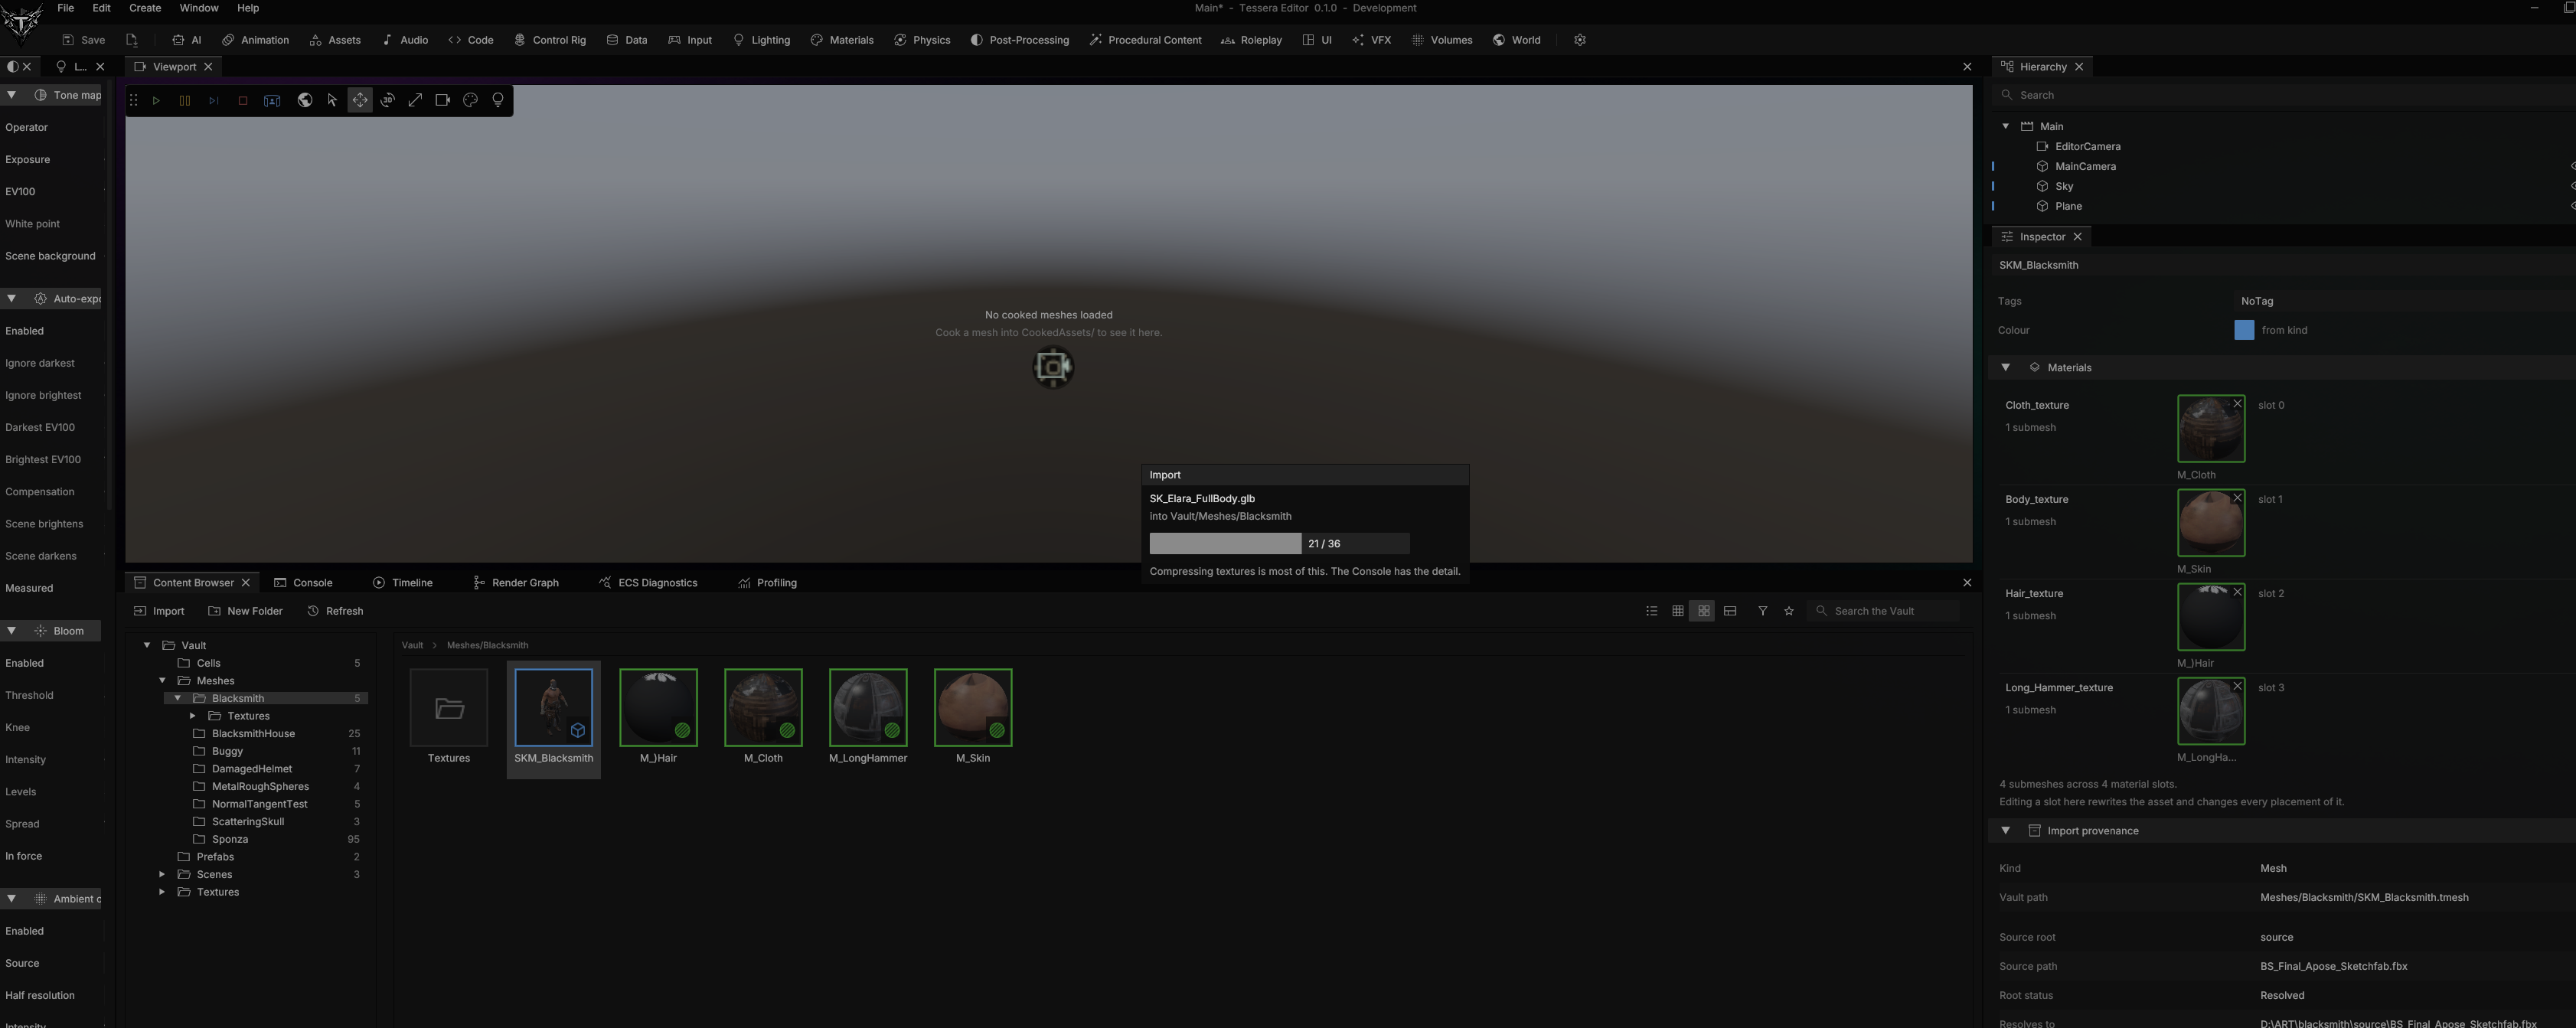
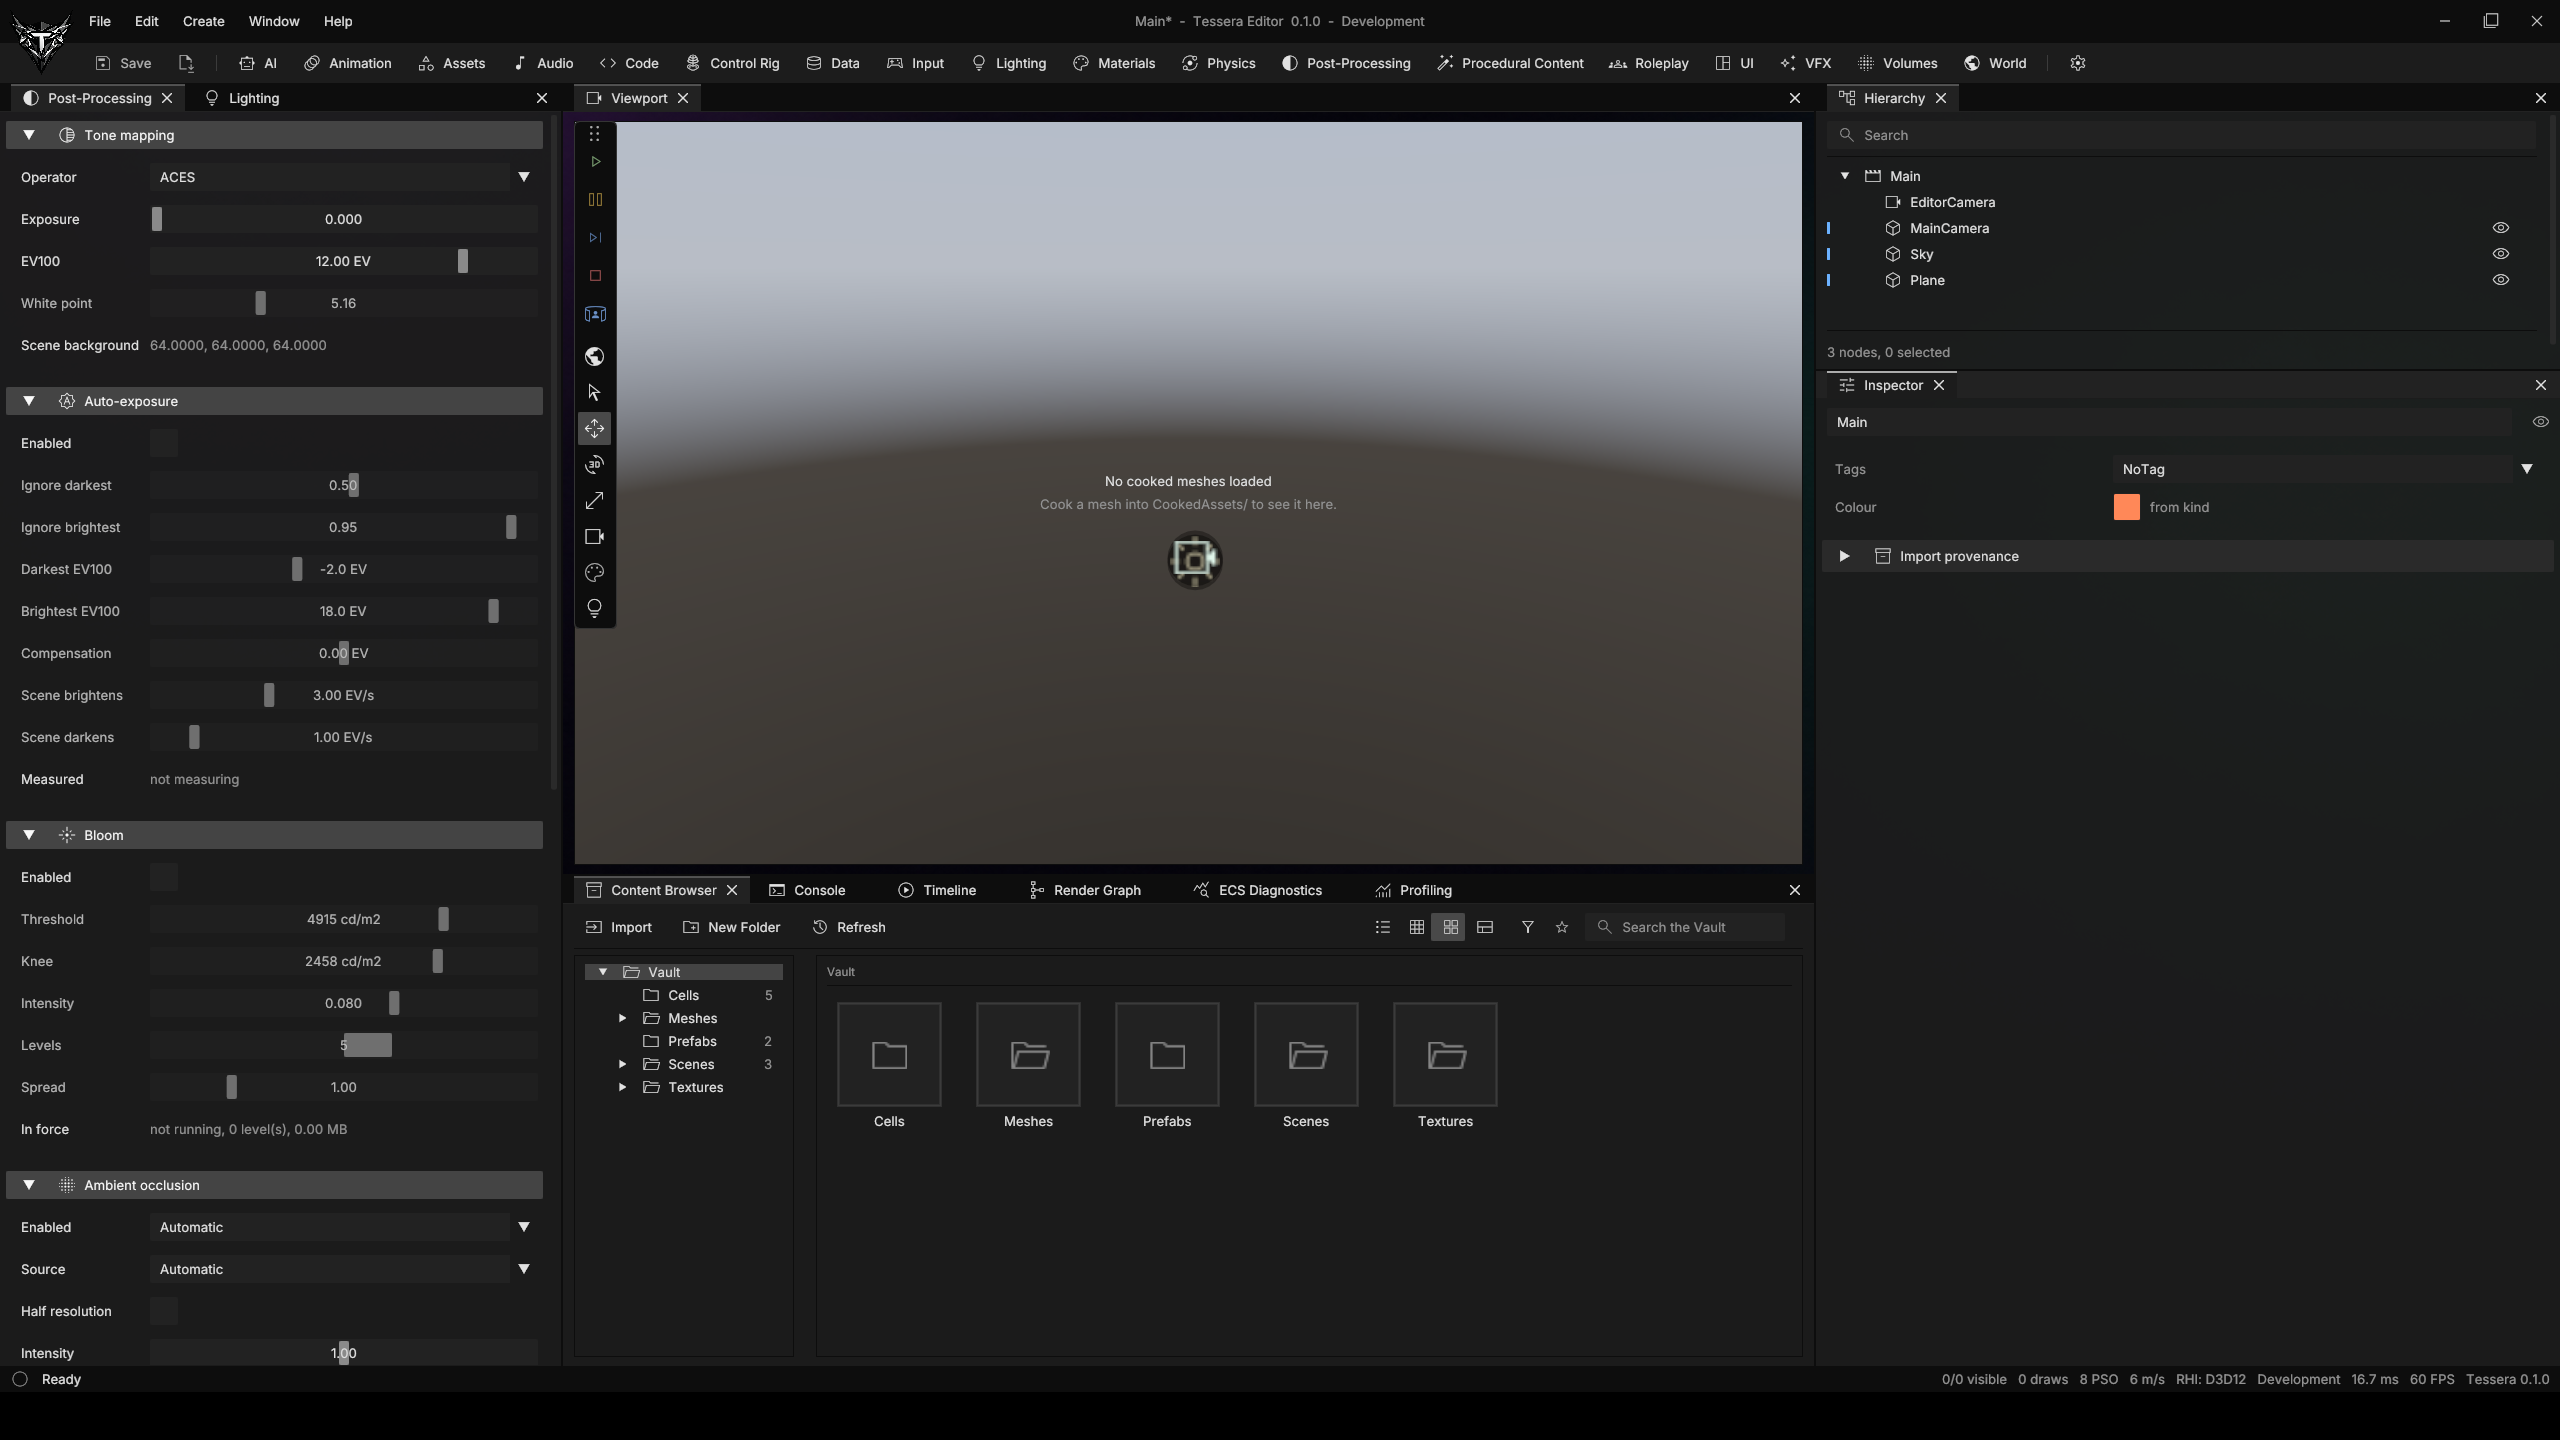
Vista del editor con docking, viewport, jerarquía, inspector y Content Browser; esta captura muestra una escena sin mallas preparadas cargadas.
Vista del editor con docking, viewport, jerarquía, inspector y Content Browser; esta captura muestra una escena sin mallas preparadas cargadas. Abrir original en una pestaña nueva

Descripción general

Piezas pequeñas, límites verificables

Tessera es el nombre de una pieza de mosaico. Cada capa tiene una responsabilidad y una dirección de dependencia definidas. La simulación no depende del renderizado; el renderizador construye un plan; el backend gráfico traduce ese plan en trabajo GPU. El editor utiliza el mismo motor que inspecciona.

Mi anterior Hibou Engine usaba OpenGL, EnTT y un editor WPF. Tessera aplica esas experiencias al control explícito de memoria y sincronización GPU, a un ECS orientado a la planificación y a un editor C++ en el mismo proceso. El motor es una biblioteca estática: los símbolos D3D12SDKVersion y D3D12SDKPath del Agility SDK deben exportarse desde el ejecutable. Ese límite explícito evita una organización frágil en DLL.

Dependencias

Arquitectura por capas

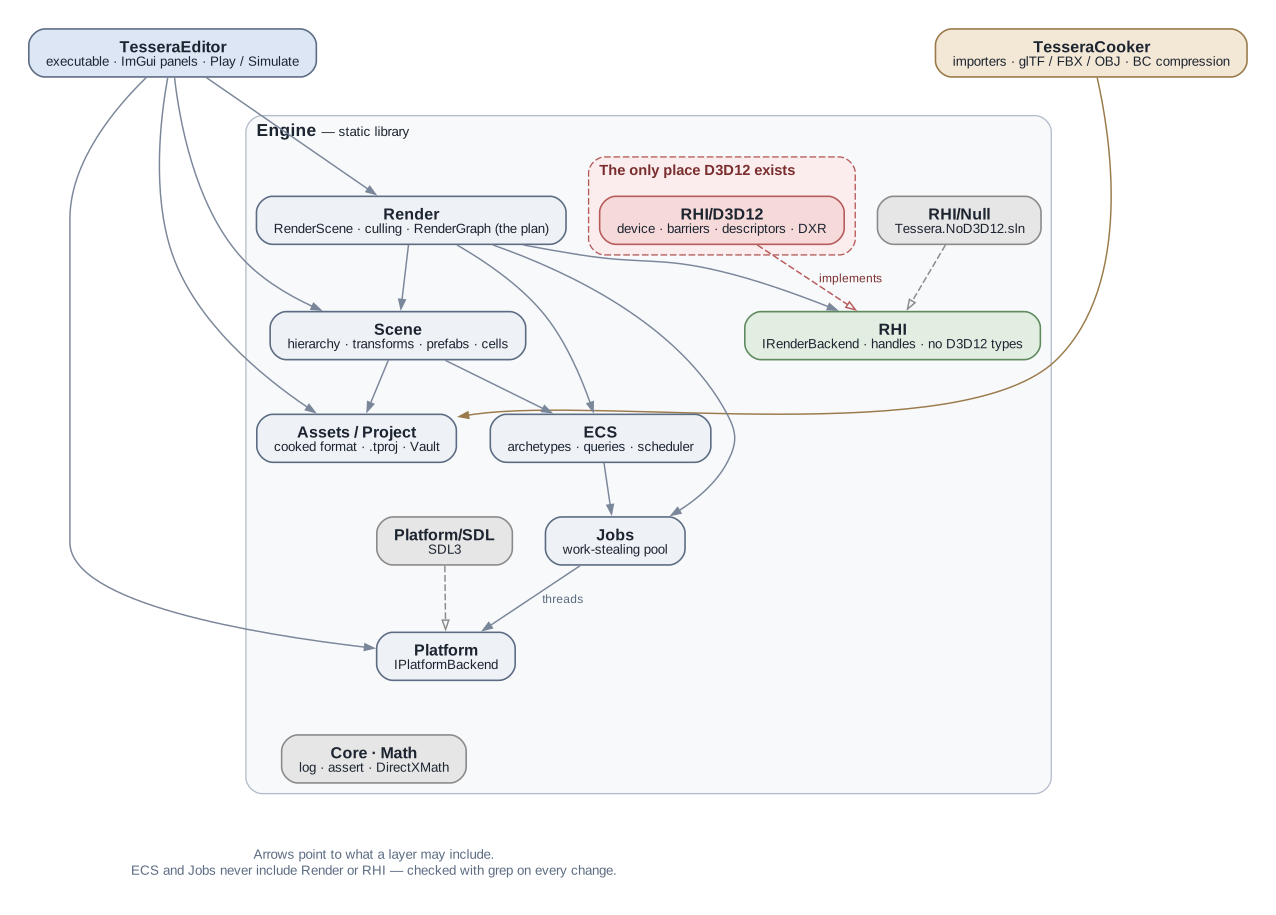
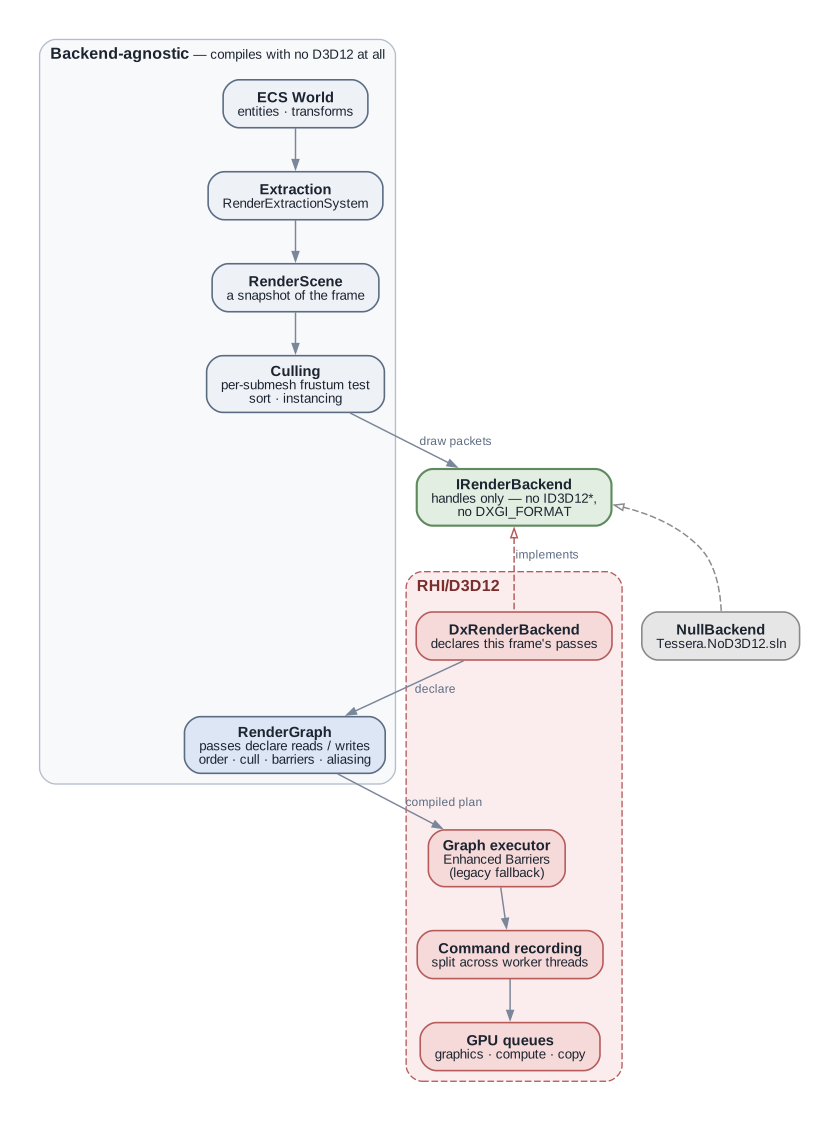
Los límites se imponen por carpetas e interfaces. Solo Platform habla con SDL3; únicamente RHI/D3D12/ incluye headers Direct3D. Render decide qué dibujar sin grabar comandos GPU. ECS, Jobs y Scene no incluyen Render/ ni RHI/; Assets y Project también permanecen independientes del renderizado.

Las bibliotecas de importación y compresión pertenecen exclusivamente a Tools/TesseraCooker. El runtime consume datos preparados sin dependencias de autoría. Las búsquedas de includes verifican esas reglas, pero compilar aporta una prueba más fuerte: Tessera.NoD3D12.sln compila motor y editor con backend nulo e interfaz SDL_Renderer. Un tipo D3D12 que escape rompe esa solución; sus builds producen cero objetos Dx*.obj.

Capas de dependencia del motor y límite aislado de Direct3D 12.
Capas de dependencia del motor y límite aislado de Direct3D 12. Abrir original en una pestaña nueva

Simulación

ECS propio diseñado para planificar

Estudié EnTT y Flecs y construí un ECS alrededor de tres requisitos: acceso de lectura/escritura declarado, cambios estructurales diferidos y deterministas, y snapshots del mundo. Una Entity contiene índice y generación en ocho bytes; la generación detecta referencias obsoletas. La persistencia usa un UUID, StableEntityId, en lugar de un handle de runtime.

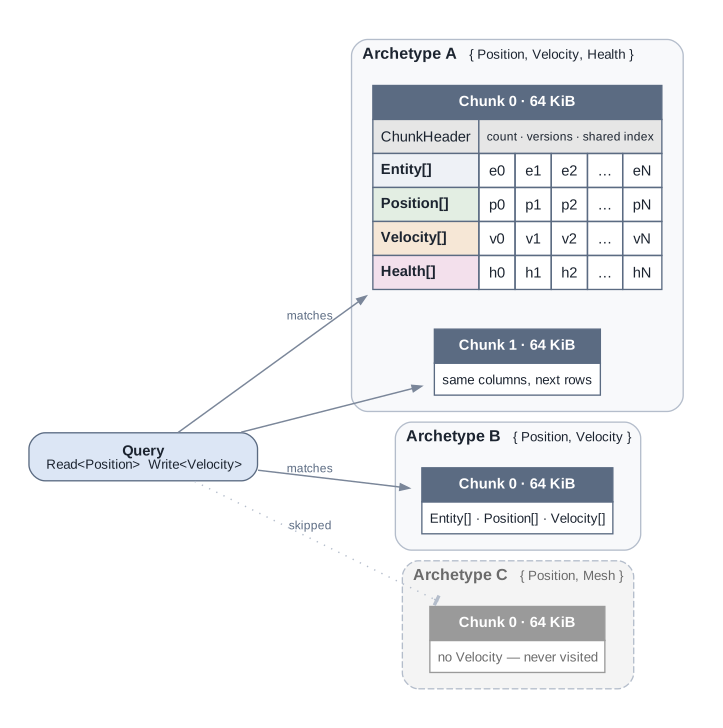
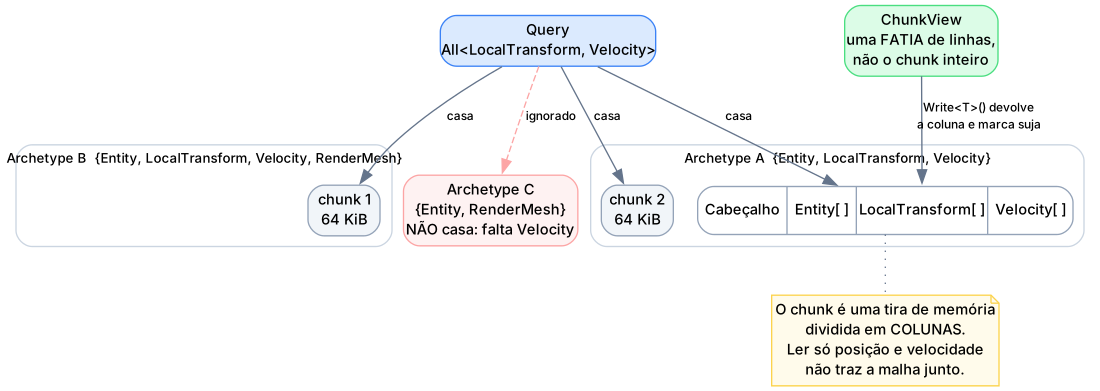
Las entidades con los mismos componentes viven en archetypes, con columnas SoA contiguas en chunks de 64 KiB. Con dos millones de entidades, 64 KiB necesitó 1.482 páginas frente a 5.955 con 16 KiB, con el mismo ancho de banda. Los sparse sets guardan componentes raros sin multiplicar archetypes. Las tablas de componentes compartidos mantienen un valor por configuración distinta, referenciado por el chunk.

Cada SystemDescriptor declara lecturas y escrituras. El scheduler deriva un DAG de dependencias y ejecuta juntos los sistemas sin conflictos. Con 32 sistemas, el coste medido fue de 0,68 µs por frame sobre 10.000 entidades y 0,86 µs sobre 1.000.000: depende de los sistemas, no del número de entidades.

Las fases fijas definen input, simulación, física, eventos, aplicación estructural, transforms y extracción para render. Crear, destruir y modificar componentes pasa por CommandBuffer, aplicado en un punto determinista. Un auditor detecta escrituras no declaradas en desarrollo y se elimina al compilar Shipping. Eventos tipados, observers y un almacén propio de jerarquía completan el modelo; la propagación por versiones evita recalcular nodos inmóviles.

El replay desde snapshot reprodujo 120 registros de auditoría idénticos durante 120 frames en la misma máquina y build. Ese es el alcance verificado del determinismo y la base del Play/Stop del editor; no se promete determinismo entre plataformas.
struct Entity
{
    uint32_t Index = InvalidEntityIndex;
    uint32_t Generation = 0;
};
static_assert(sizeof(Entity) == 8,
    "Entity is a chunk column; its size is layout.");
Archetypes divididos en chunks con columnas contiguas de componentes.
Archetypes divididos en chunks con columnas contiguas de componentes. Abrir original en una pestaña nueva

Concurrencia

Work stealing sin bloquear el frame

Cada worker posee un deque Chase-Lev: apila y desapila sin lock mientras los workers inactivos roban del otro extremo. Un worker que espera un job ejecuta otras tareas en su pila actual. El test con un solo worker verifica que las dependencias progresen. Los threads externos al pool esperan pasivamente; permitirles ayudar crearía dos productores para un deque que solo admite uno.

Los jobs tienen afinidad AnyWorker, LongRunning o MainThread. Contadores separados siguen el trabajo del frame y el de larga duración, evitando que compilar shaders prolongue la espera del frame. En la comparación registrada, el frame más lento durante una recompilación bajó de 803 ms a 18,75 ms. FrameArena por worker ofrece memoria temporal; ParallelFor sobre 1.048.576 elementos produjo el resultado serial con cero asignaciones de heap.

Durante el desarrollo aparecieron tres defectos de concurrencia, uno solo con la ventana del editor visible. Un watchdog que identifica la etapa bloqueada ayudó a aislarlo. Cambiar el robo por lotes a robo por elemento trasladó ese coste al thread inactivo. Un grafo amplio de trabajo real registró 94,7% de ocupación de workers.

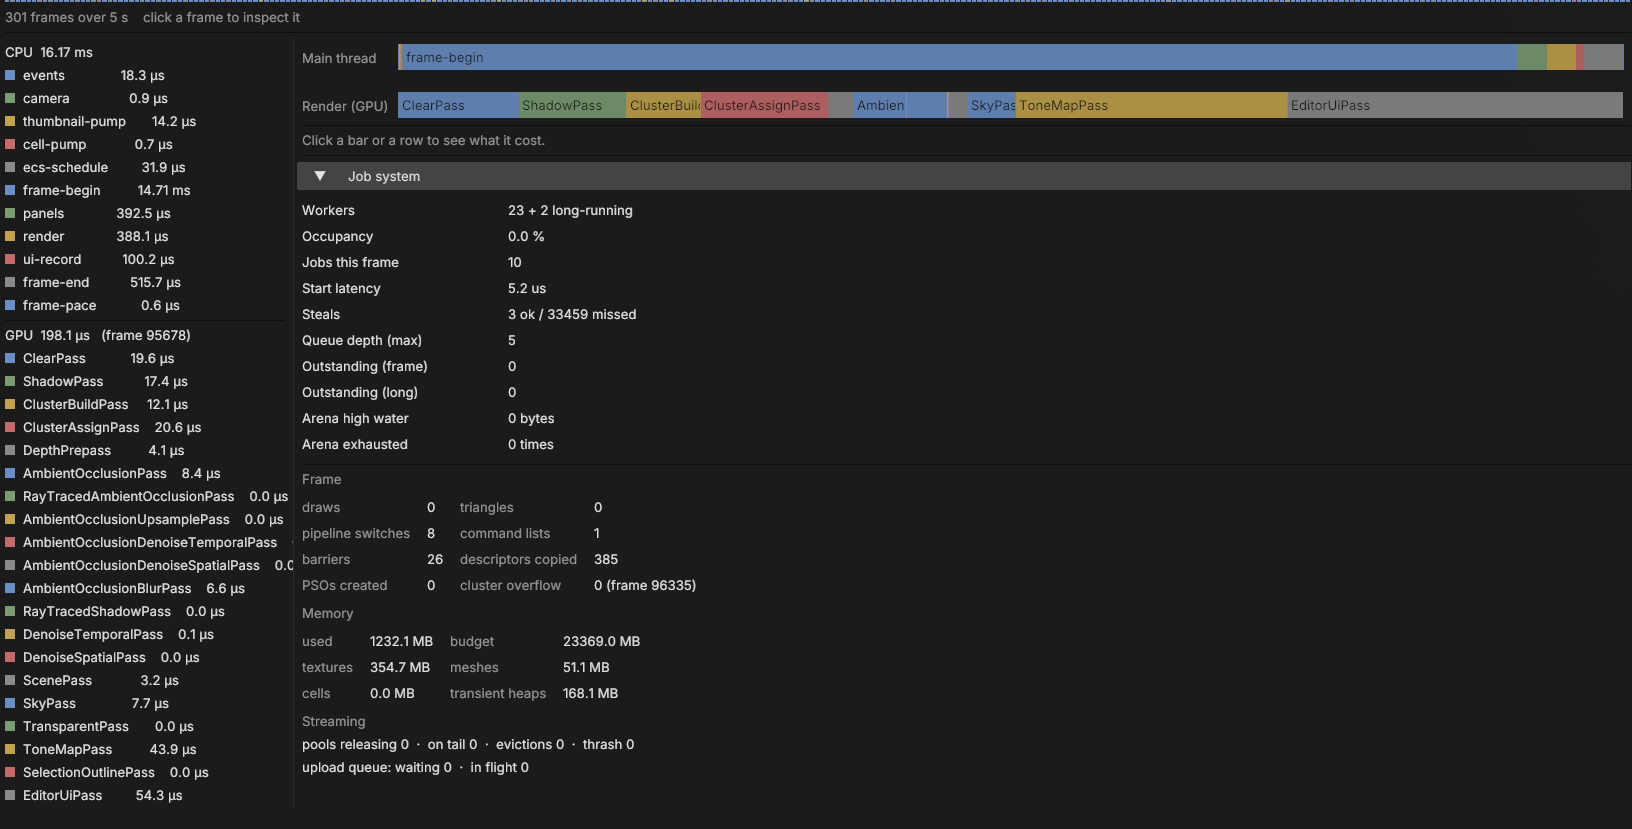
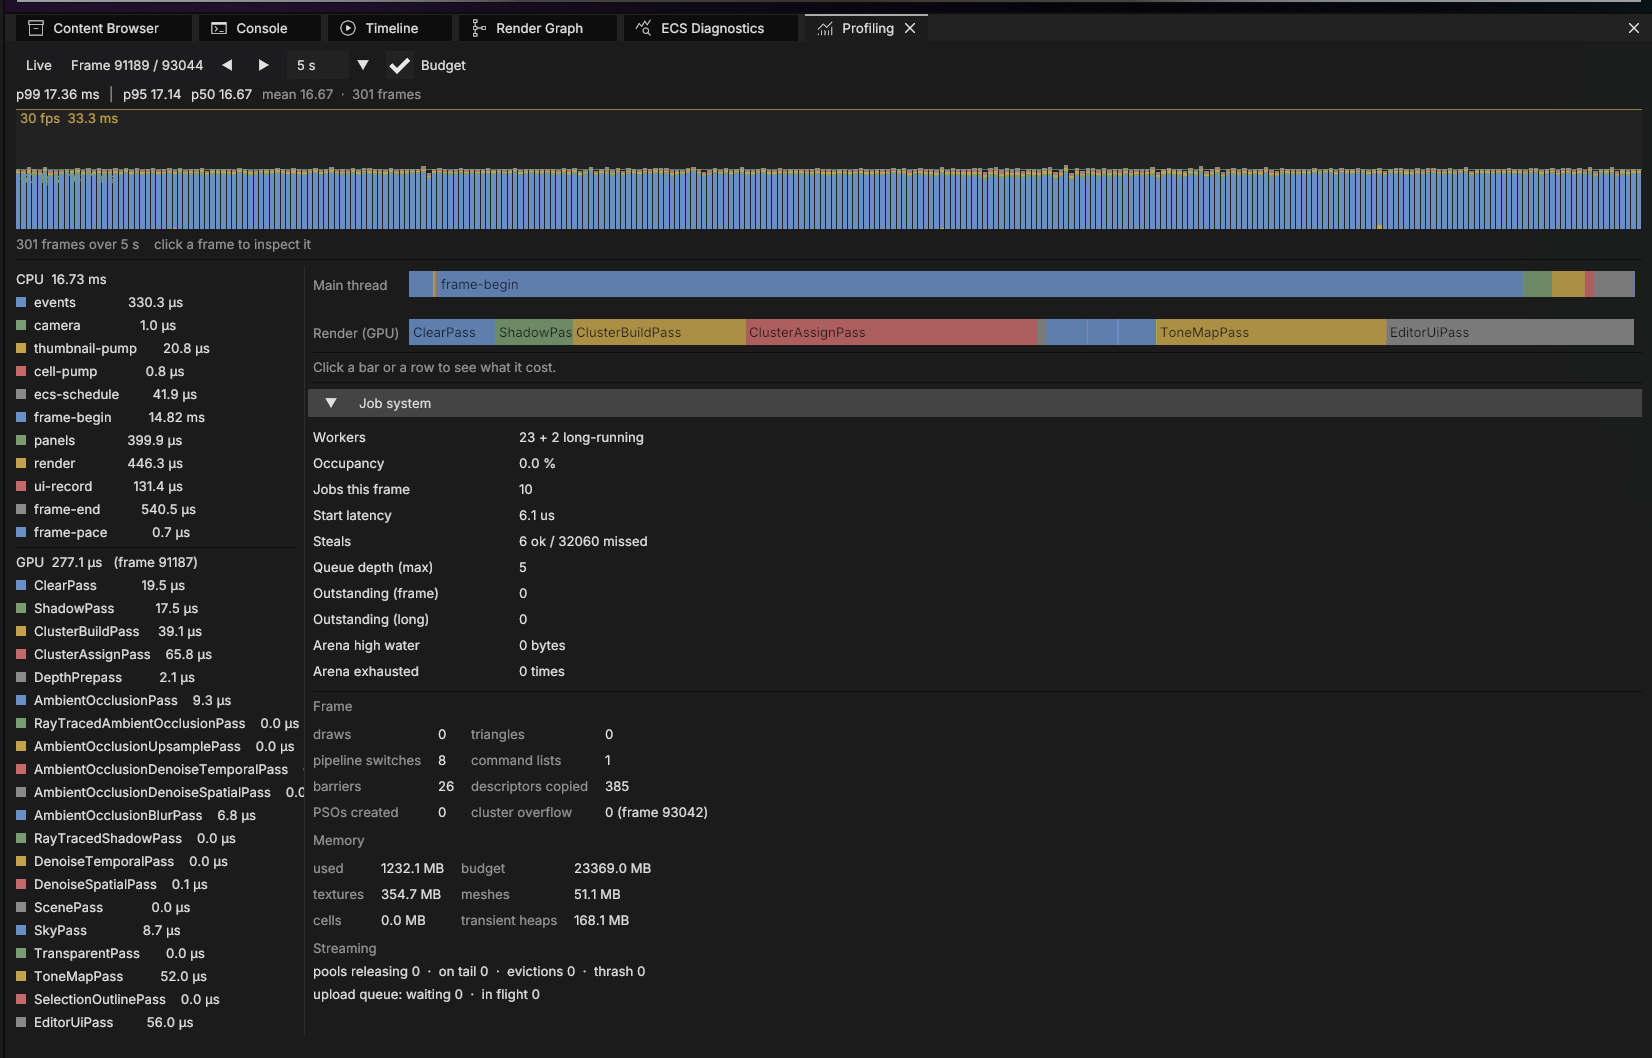
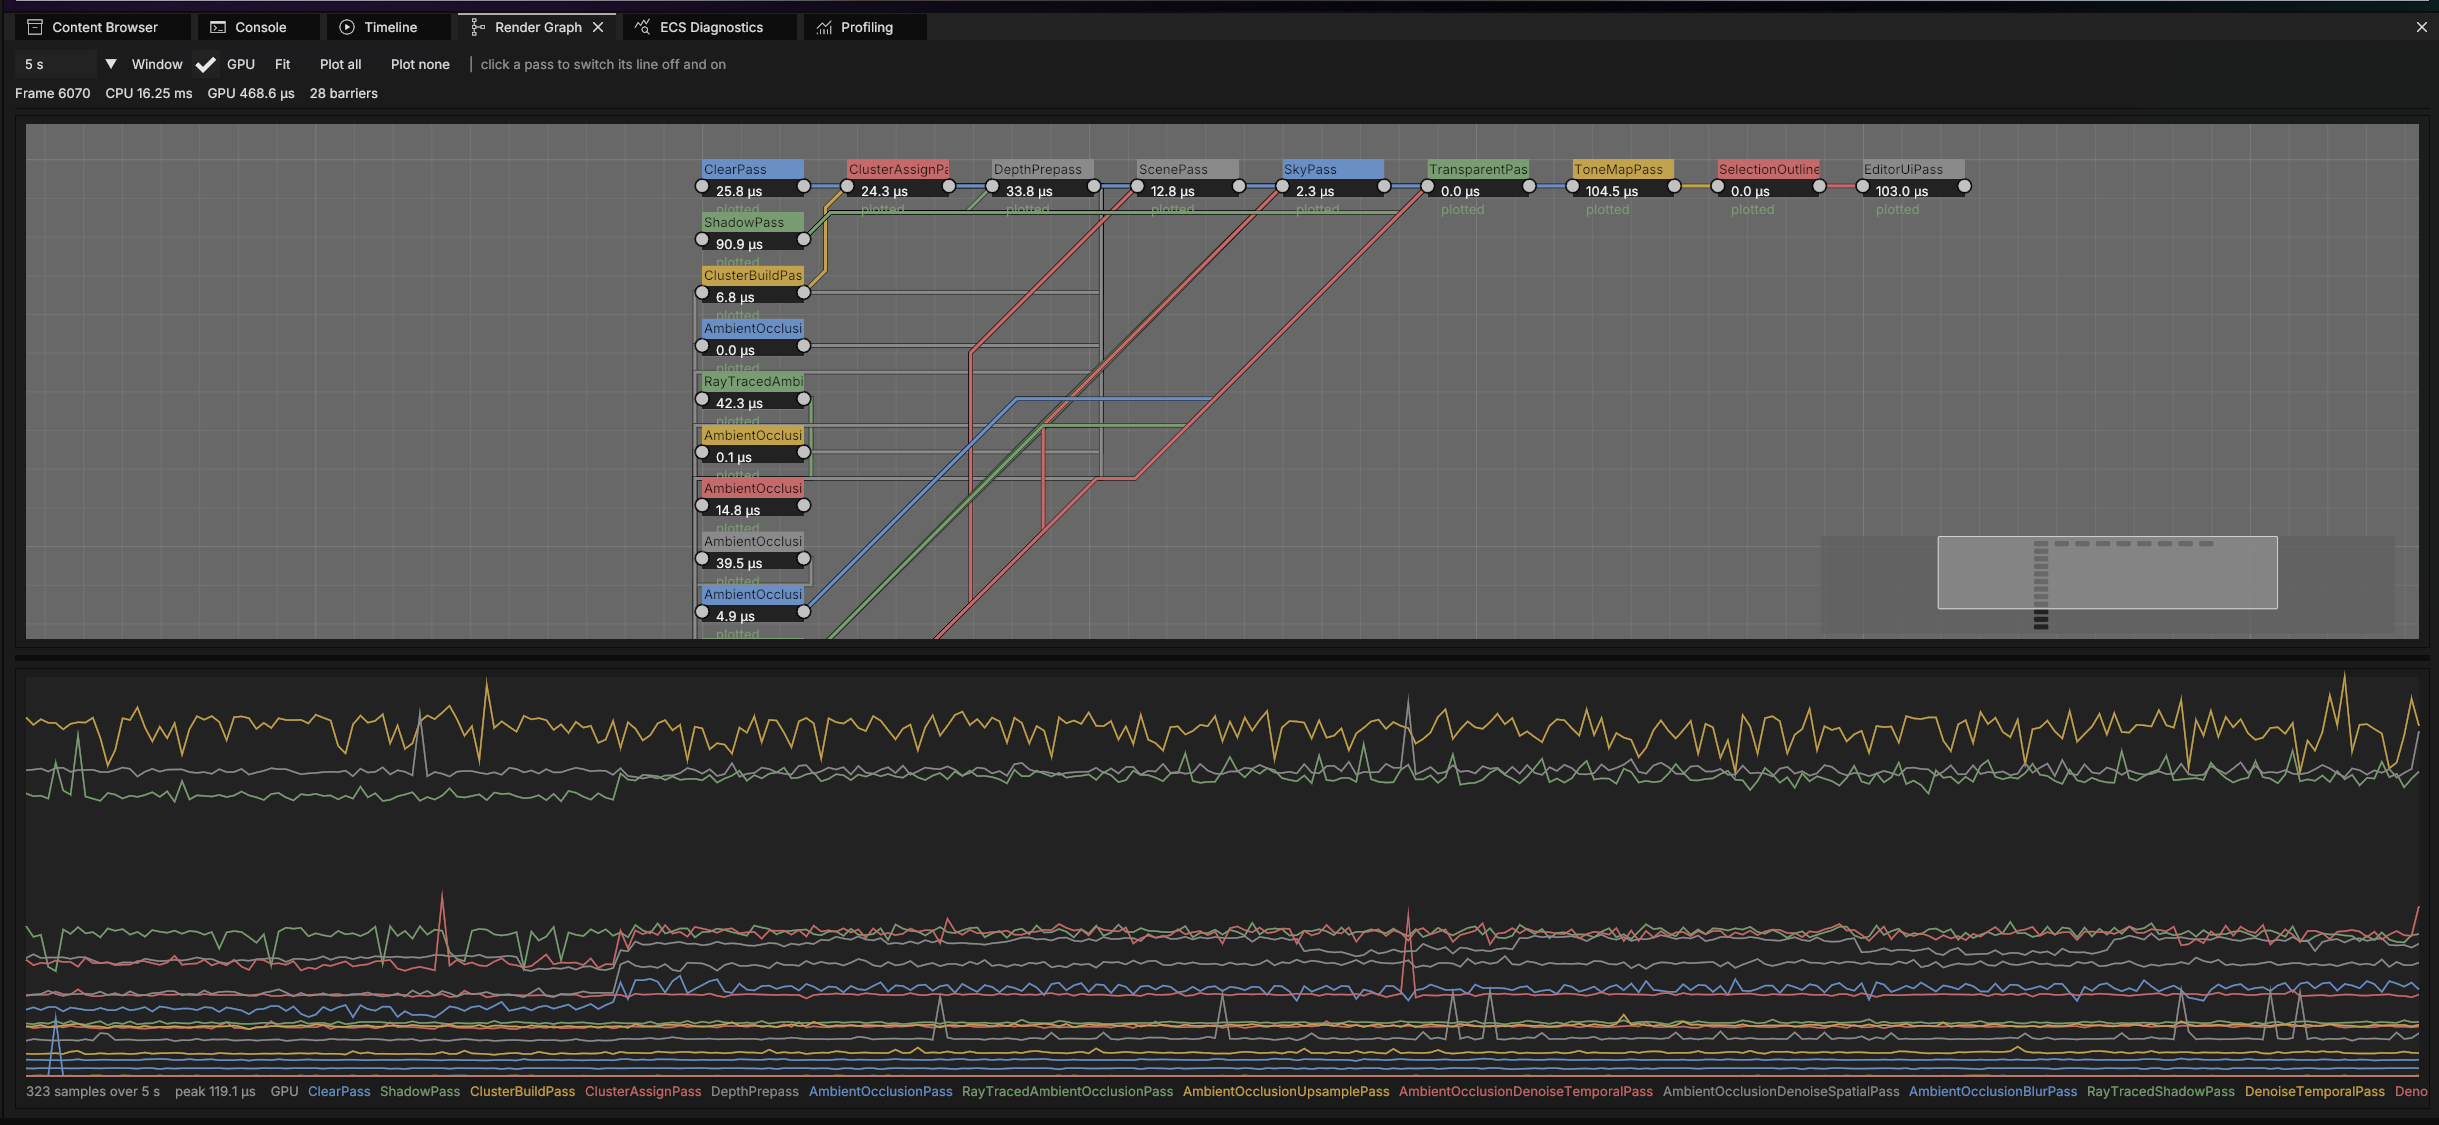
El cooker usa el mismo sistema: comprimir una textura 2048² llevó 311,8 s con un thread y 9,7 s con 24. Tracy y una timeline del editor muestran actividad CPU/GPU y trabajo por worker. Son mediciones específicas del proyecto, no garantías generales de throughput.

Timeline de profiling con jobs por worker.
Timeline de profiling con jobs por worker. Abrir original en una pestaña nueva

Persistencia

Un contenedor, muchos chunks

Importar un modelo significa prepararlo para el runtime. Un proyecto Tessera guarda formatos del motor y referencia el original mediante una raíz de origen con nombre; nunca copia el original al proyecto y rechaza rutas de origen absolutas. Así separa los datos portátiles del proyecto de los archivos de autoría necesarios para reimportar.

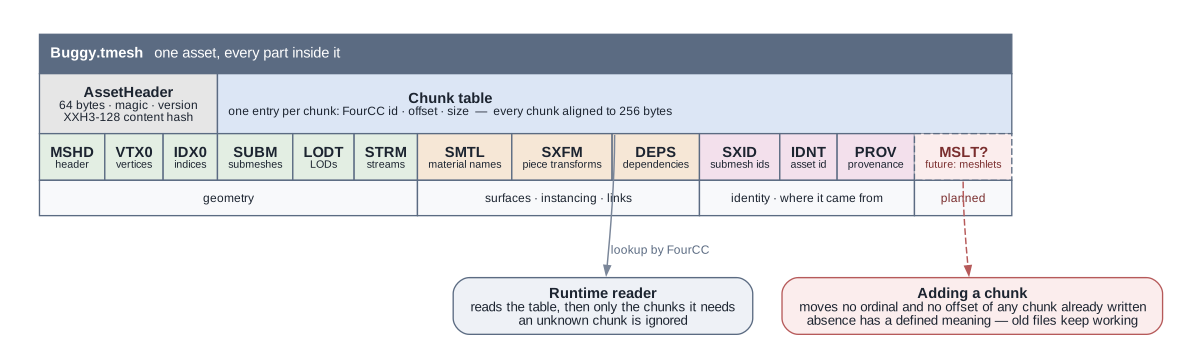
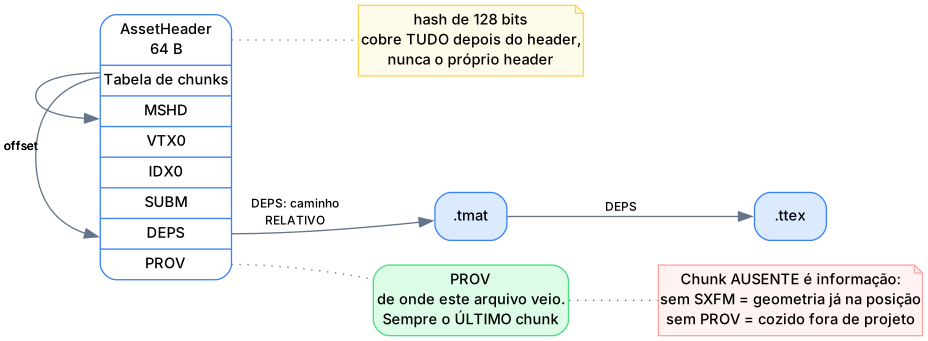
Los formatos binarios comparten un header de 64 bytes con magic, versión, hash XXH3-128 y posición de la tabla de chunks. Entradas FourCC localizan chunks alineados a 256 bytes. El runtime lee solo el mip o LOD necesario. PROV registra ruta y hash de origen, versión del cooker y opciones; escanear un proyecto sin cambios llevó 102 ms frente a 316 s para volver a prepararlo. IDNT conserva el UUID entre reimportaciones.

Un .tmesh contiene un asset completo con submeshes internos: el buggy convierte 109 mallas en un archivo con 236 submeshes. SXFM guarda transforms por pieza, permitiendo almacenar una rueda una vez y colocarla cuatro veces. En la colección medida, el almacenamiento bajó de 39,9 MB a 31,0 MB y los draws de 342 a 229.

La ausencia de chunks opcionales tiene un significado definido: sin SXFM, el transform es identidad. PROV se añadió sin aumentar la versión; SXFM elevó la versión de la malla manteniendo los archivos antiguos abiertos y renderizados correctamente. La evolución del formato se convierte en una decisión explícita de compatibilidad.

FormatoResponsabilidad
.tmeshAsset de malla, submeshes y LODs
.ttexTexturas y mips comprimidos BC; BC6H para HDRI
.tmatMaterial OpenPBR
.tscn / .tpfb / .tcellNivel, prefab y celda de streaming
.tprojDescriptor de proyecto JSON, fuera del contenedor binario
Estructura de la malla preparada y futura extensión de meshlets.
Estructura de la malla preparada y futura extensión de meshlets. Abrir original en una pestaña nueva

Extensión prevista

Preparando el camino hacia mesh shaders

Los mesh shaders no están implementados en el renderizador. El pipeline existente deja ese camino abierto: los slots de la root signature canónica son visibles para todas las etapas, los pipelines usan pipeline state stream, DXC reconoce ms y as desde Shader Model 6.5 y la detección de capacidades consulta el soporte de la GPU.

Un test creó un pipeline de mesh shader con esa root signature. Verifica compatibilidad, no una ruta de renderizado entregada. meshoptimizer está elegido pero no integrado. El plan es que el cooker genere meshlets en un nuevo chunk .tmesh; los archivos antiguos conservarán el camino tradicional de vértices cuando falte. Los contratos del contenedor y del pipeline permiten esa extensión.

Límite GPU

El renderizador planifica; el backend ejecuta

IRenderBackend no expone tipos Direct3D. Los recursos usan handles con generación, como Handle<TextureTag> y Handle<MeshTag>, para detectar referencias a objetos liberados. Render/ construye un plan independiente de la GPU; RHI/D3D12/ lo ejecuta. La planificación se puede probar sin device.

El backend usa Enhanced Barriers por defecto con fallback legacy, y bindless Shader Model 6.6 con fallback a tablas de descriptores. Su root signature ocupa 13 de 64 DWORDs. Una cola de copia separada gestiona uploads; el streaming con presupuesto VRAM reduce los mips bajo presión en vez de eliminar la escena. El hot reload de shaders reconstruye los pipelines afectados.

La grabación multithread se elige donde la carga la justifica. Con 23.099 draws, el tiempo CPU del frame bajó de 207–229 ms a 82–91 ms, una mejora de 2,3–2,8×. El frame habitual y pequeño conserva deliberadamente una sola lista de comandos. El coste adicional de planificación y grabación debe justificarse.

El plan de render cruza una interfaz abstracta antes de ejecutarse en el backend D3D12.
El plan de render cruza una interfaz abstracta antes de ejecutarse en el backend D3D12. Abrir original en una pestaña nueva

Compilación del frame

Un render graph que produce un plan

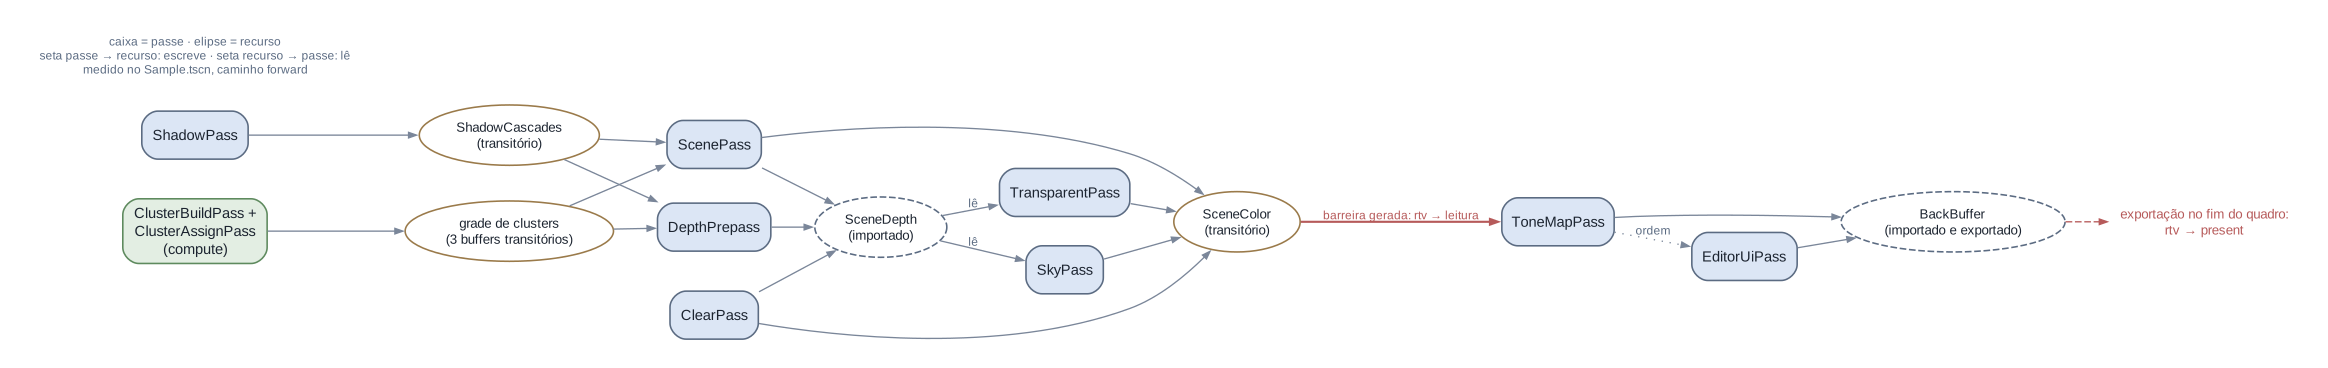
Un pase declara lecturas y escrituras de recursos, tipos de acceso y etapas GPU. El grafo ve el frame completo y deriva orden y barreras de esas declaraciones. Nunca graba comandos. El ejecutor D3D12 lee el orden y las barreras por pase y graba el trabajo correspondiente.

La compilación construye dependencias respecto al último escritor anterior, rechaza ciclos con un plan vacío, elimina productores sin uso, elige colas, calcula vidas de recursos transitorios y genera barreras cuando cambia su función. Los recursos exportados y efectos secundarios declarados preservan el trabajo necesario; importar un recurso no protege a su productor de la eliminación.

Orden de uso y tiempo de vida difieren con compute opcional: las posiciones del plan no describen ejecuciones solapadas. El grafo aporta intervalos de vida; el dueño de los heaps decide aliasing y pide sus barreras. Mi asignador empaqueta por vida, requisito que motivó rechazar el enfoque por tamaño del D3D12 Memory Allocator evaluado. Ocho recursos escalonados intencionalmente usaron 2.688 KB frente a 10.752 KB, reducción de 4,00× y el mínimo para ese test.

El grafo forward proporcionado se exportó de Sample.tscn el 6 de octubre de 2026. En esa configuración registrada, 20 pases producen 15 barreras. Seis pases desactivados de oclusión/ray tracing solo abren scopes vacíos: un pase sin escrituras no es un productor sin uso y no se elimina automáticamente. La transición destacada de SceneColor antes de ToneMapPass se deduce del cambio de render target a lectura de shader. Las cuentas varían con el camino de shading y los efectos activos.

Reset() limpia los datos del frame conservando capacidad de los vectores; los handles de recursos del grafo caducan con él. La exportación Graphviz y el panel del editor muestran el plan; --rendergraph-self-test ejecuta 242 verificaciones sin GPU.

  1. Declarar

    Importar recursos existentes con su estado inicial; crear transitorios indefinidos; usar AddPass para declarar Read, Write o ReadWrite.

  2. Compilar

    Exportar estados finales requeridos, incluido present para el backbuffer. Compile() deriva el orden, los tiempos de vida y la sincronización.

  3. Ejecutar

    El backend consume GetExecutionOrder() y GetBarriers() y emite trabajo GPU. La planificación permanece independiente de Direct3D 12.

Grafo forward exportado de Sample.tscn el 6 de octubre de 2026; el grafo deduce la transición destacada de SceneColor.
Grafo forward exportado de Sample.tscn el 6 de octubre de 2026; el grafo deduce la transición destacada de SceneColor. Abrir original en una pestaña nueva

Renderizado

Iluminación con una referencia de comparación

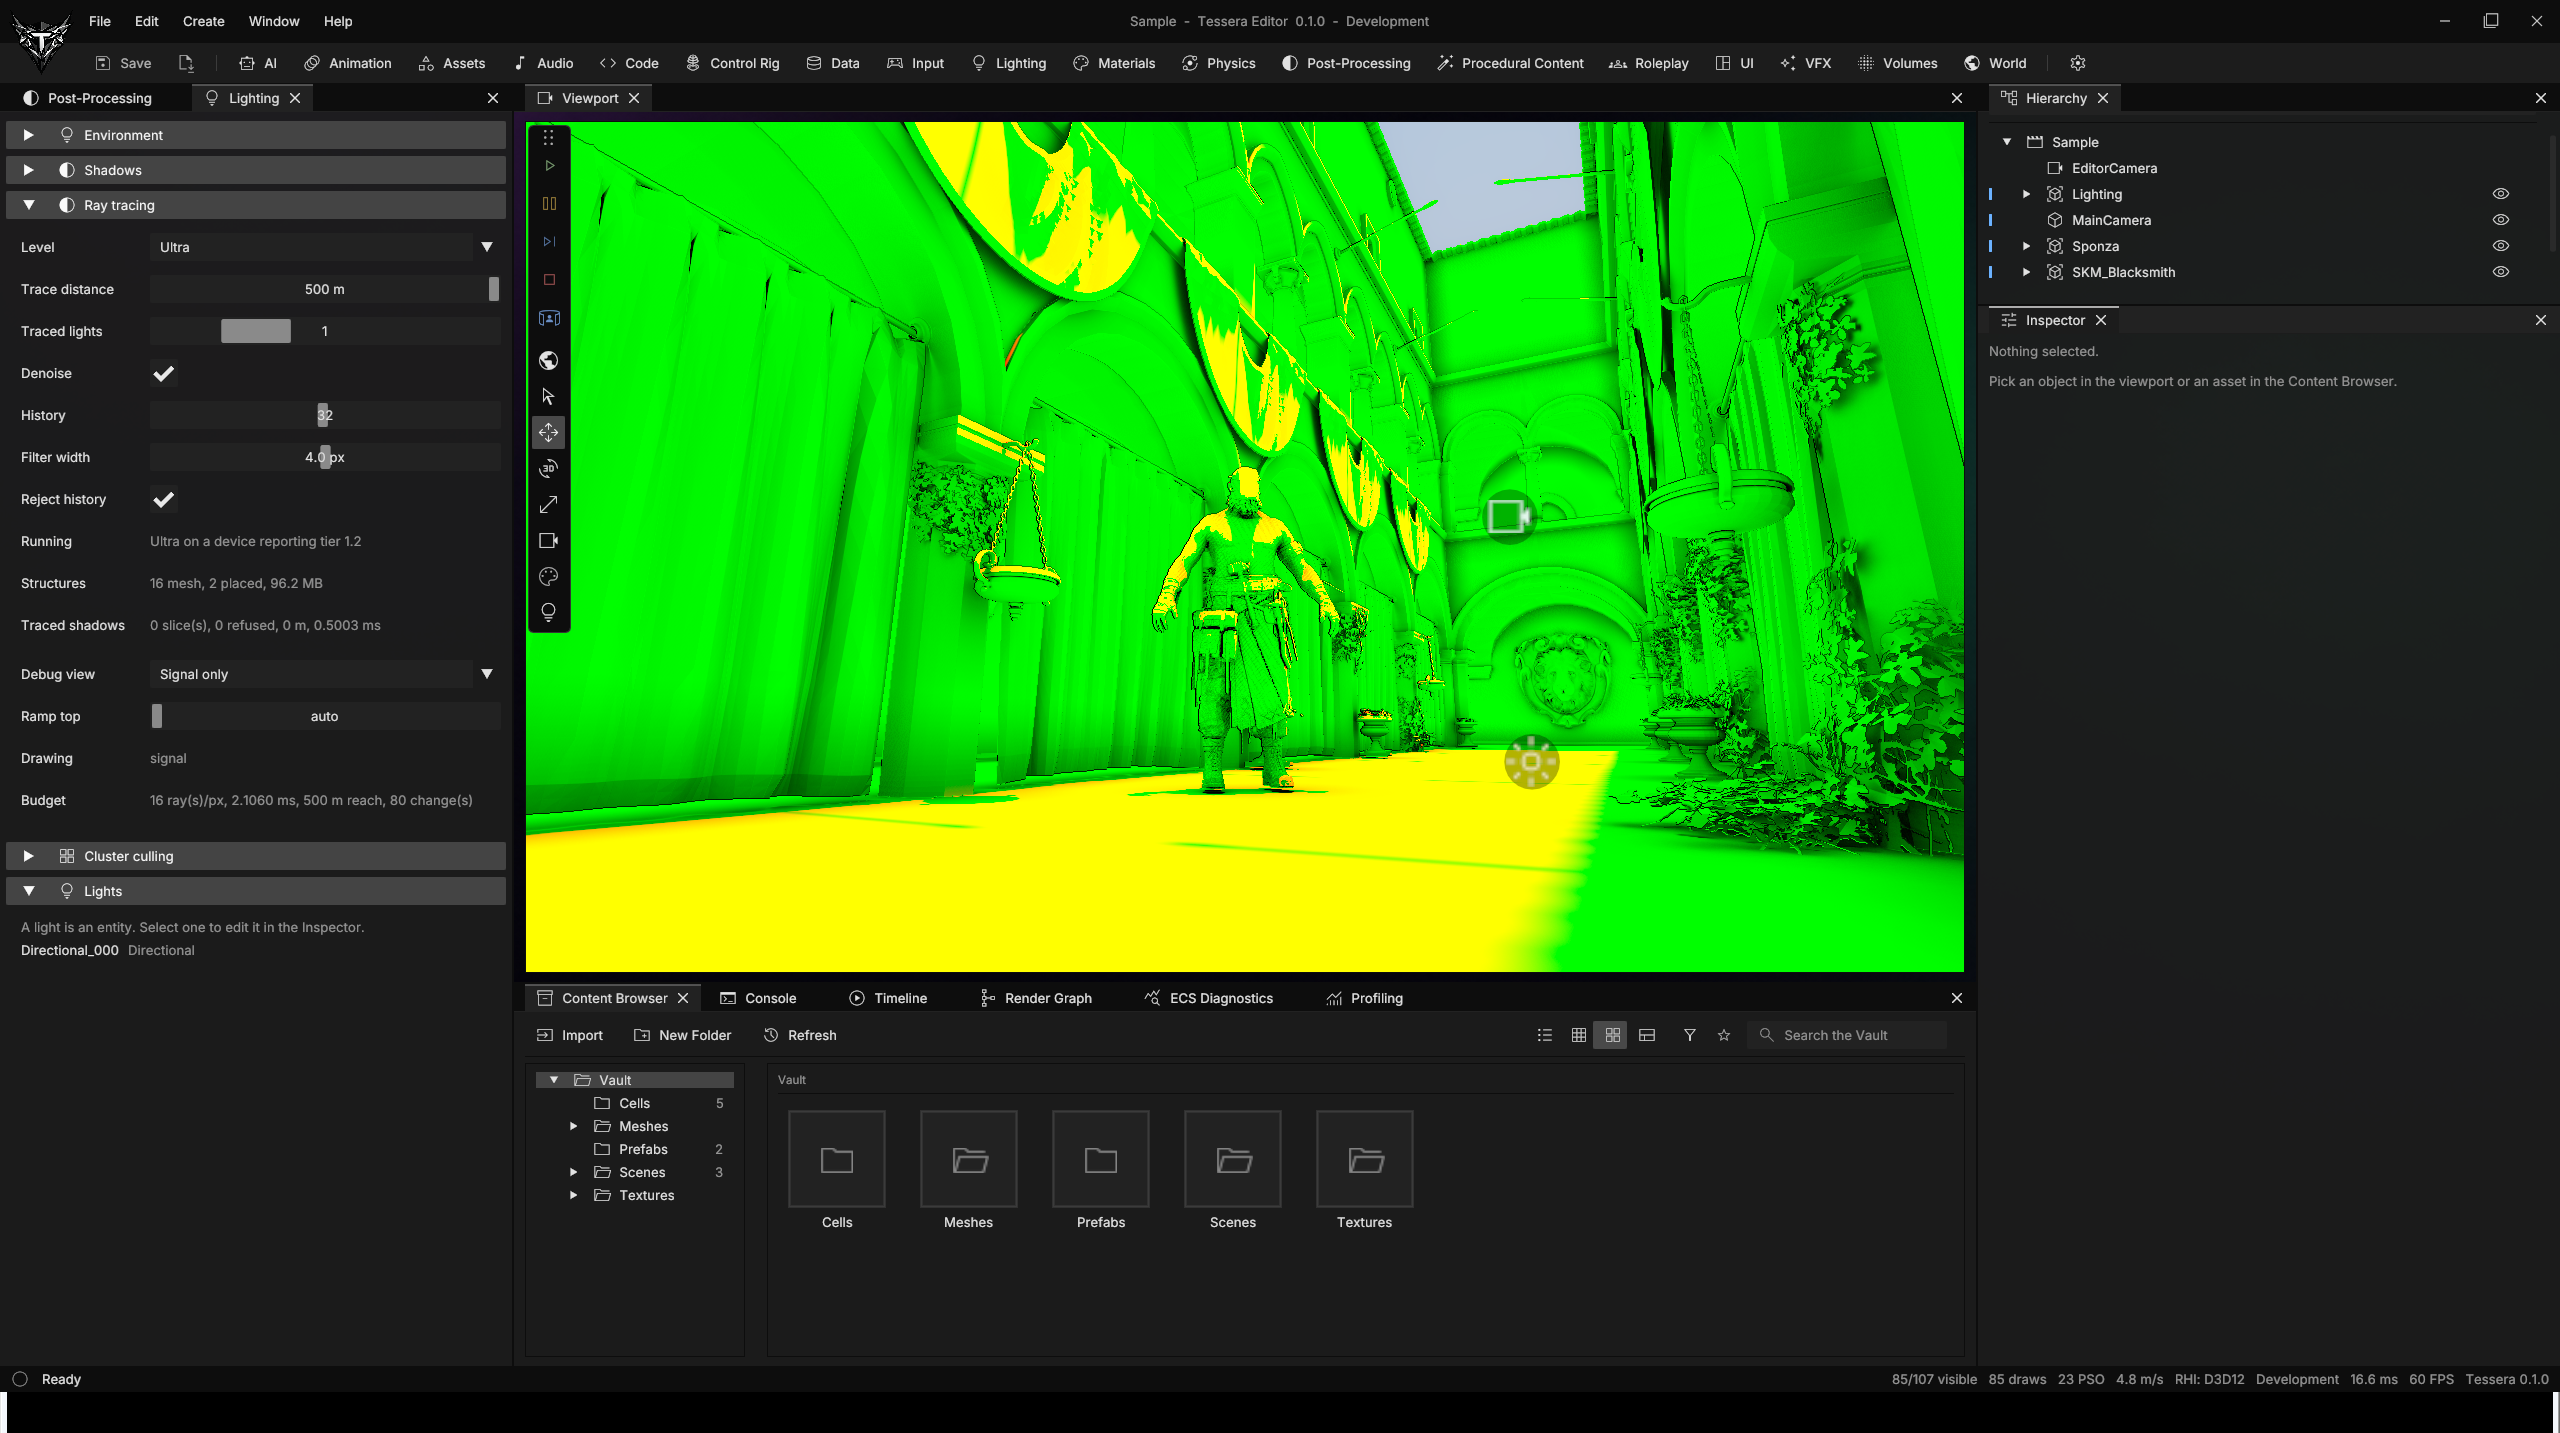
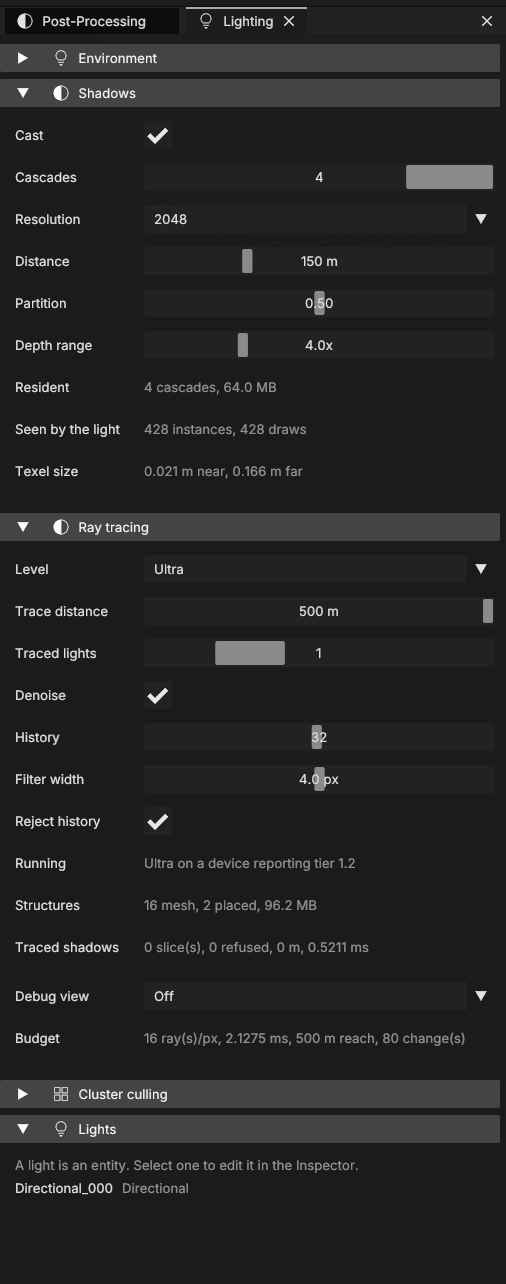
El renderizador implementa coat, anisotropía y fuzz OpenPBR, verificados con furnace test; iluminación basada en imagen, cielo procedural y HDRI; sombras en cascada y clustered light culling. En el test registrado, 125× más luces costaron 1,39×. Forward y deferred son intercambiables, con SSAO, bloom, autoexposición por histograma y transparencia.

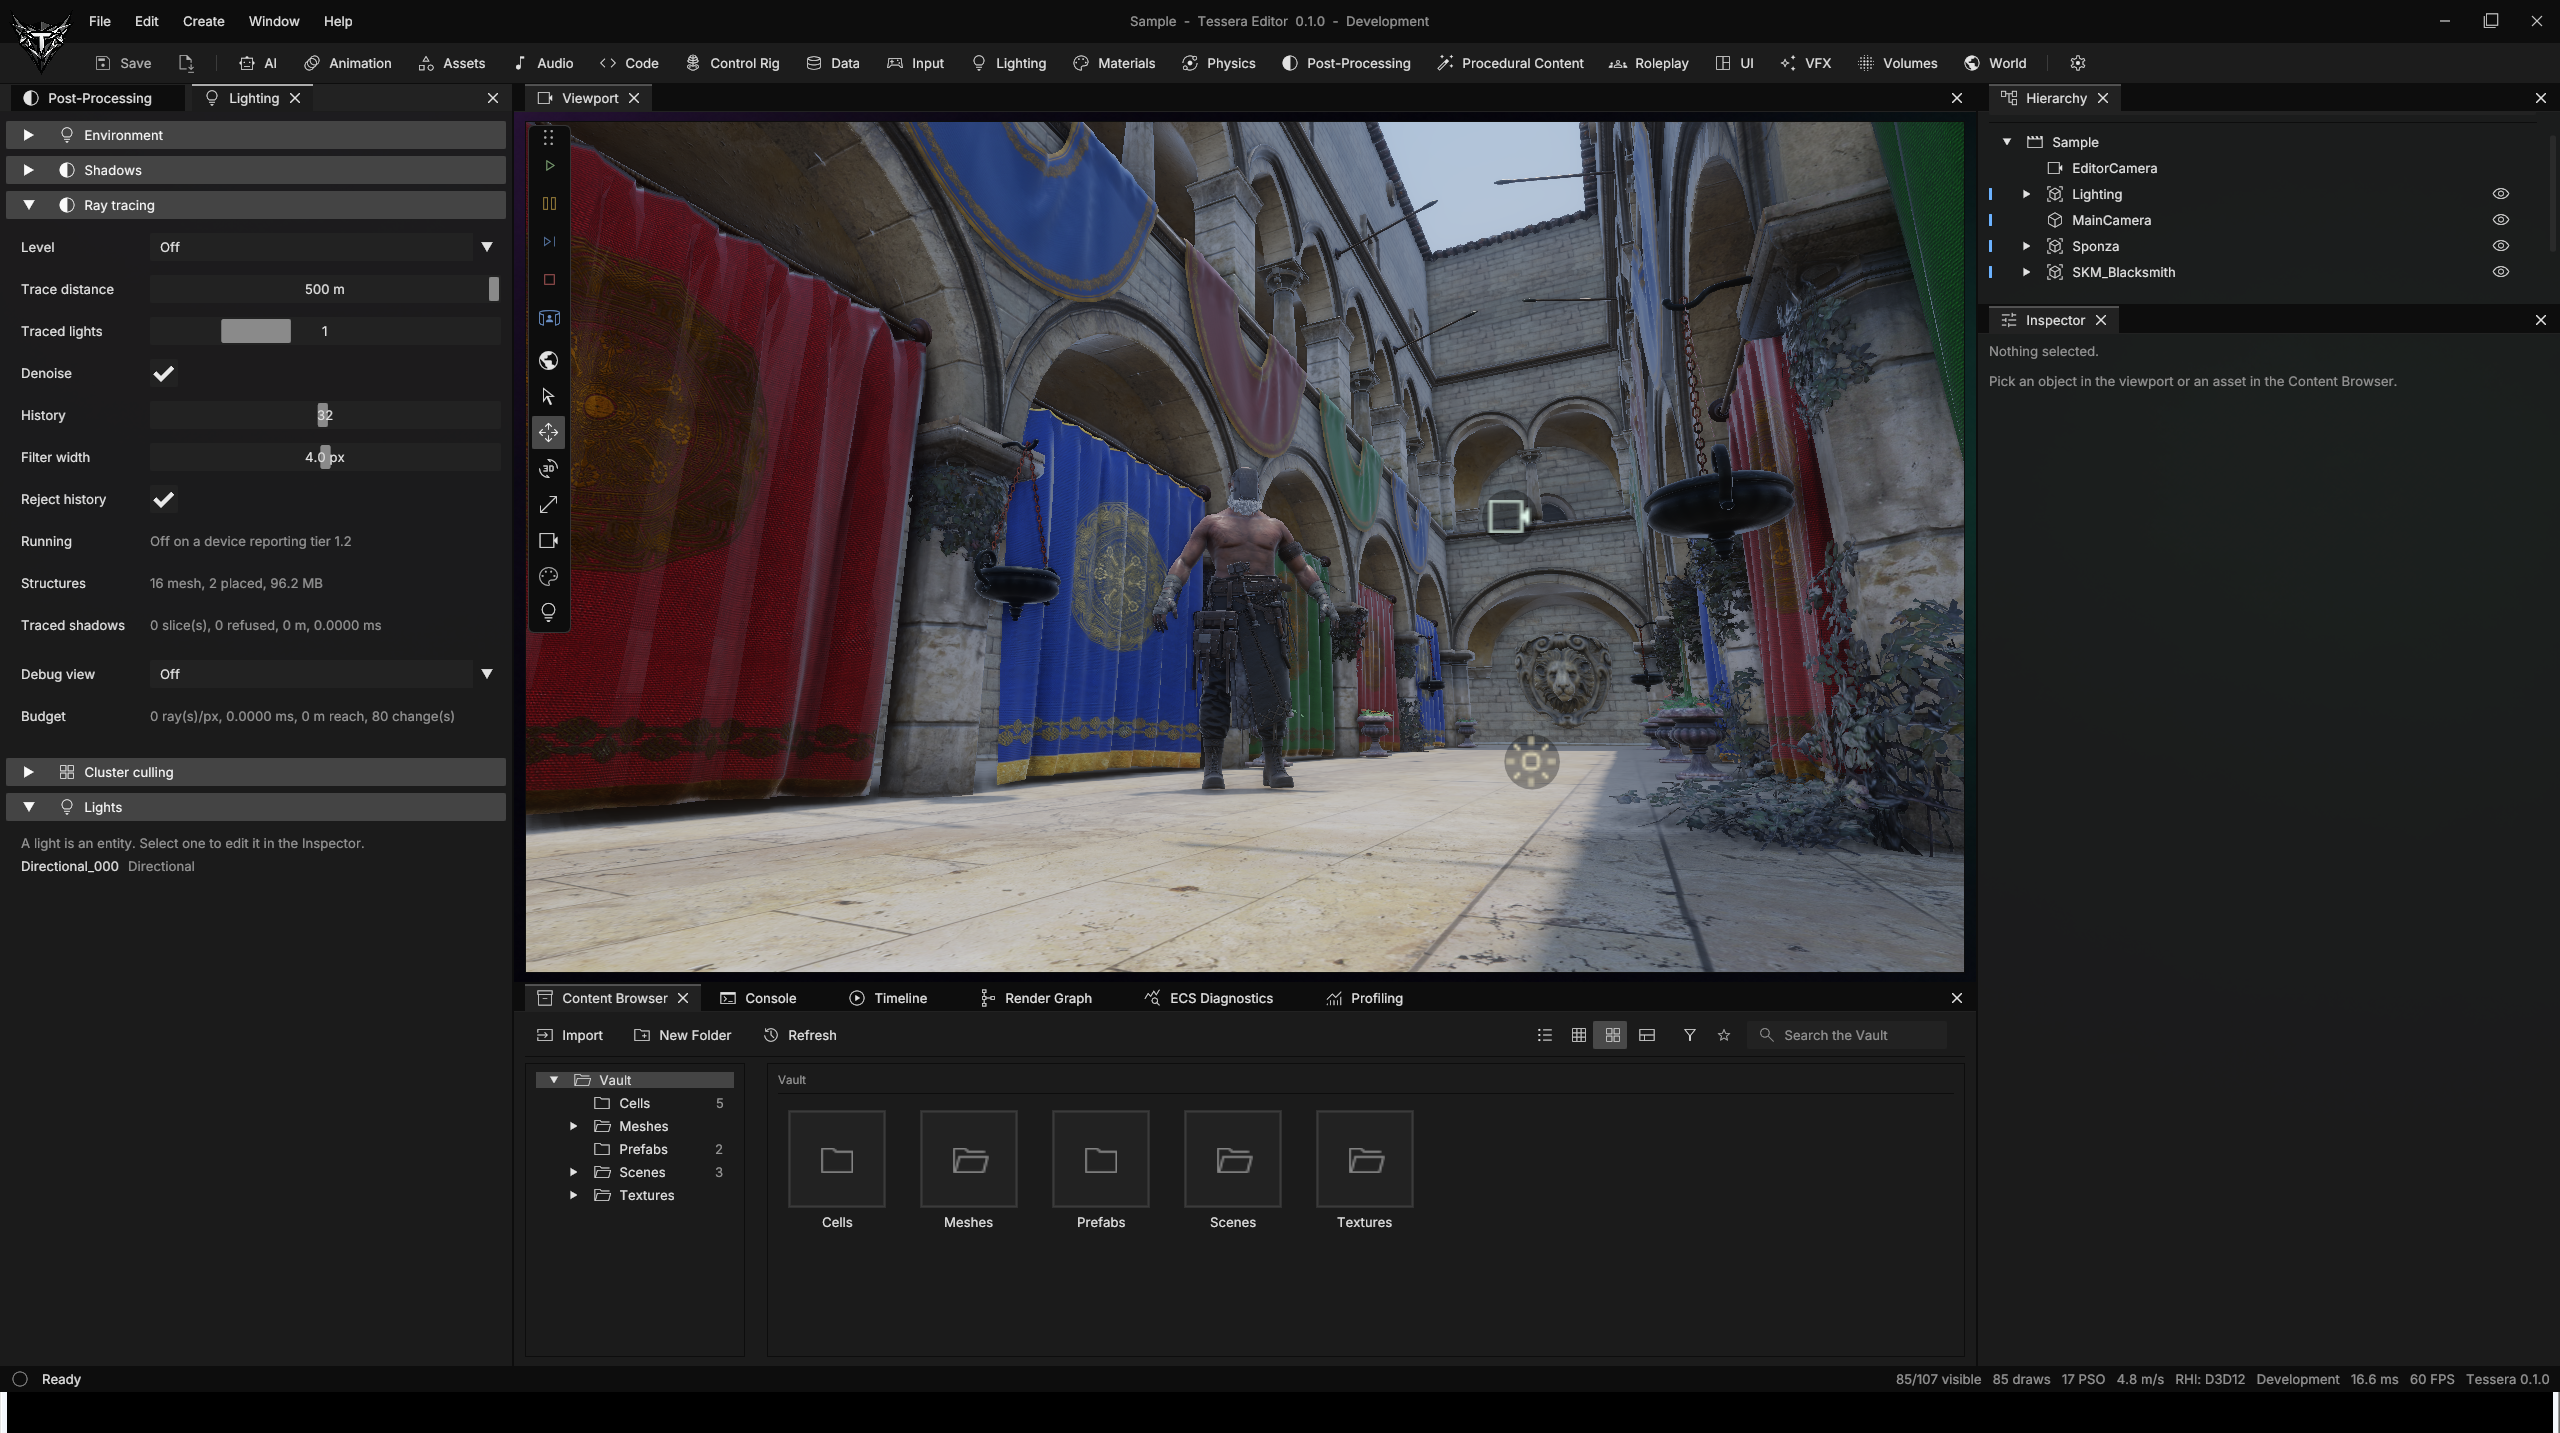
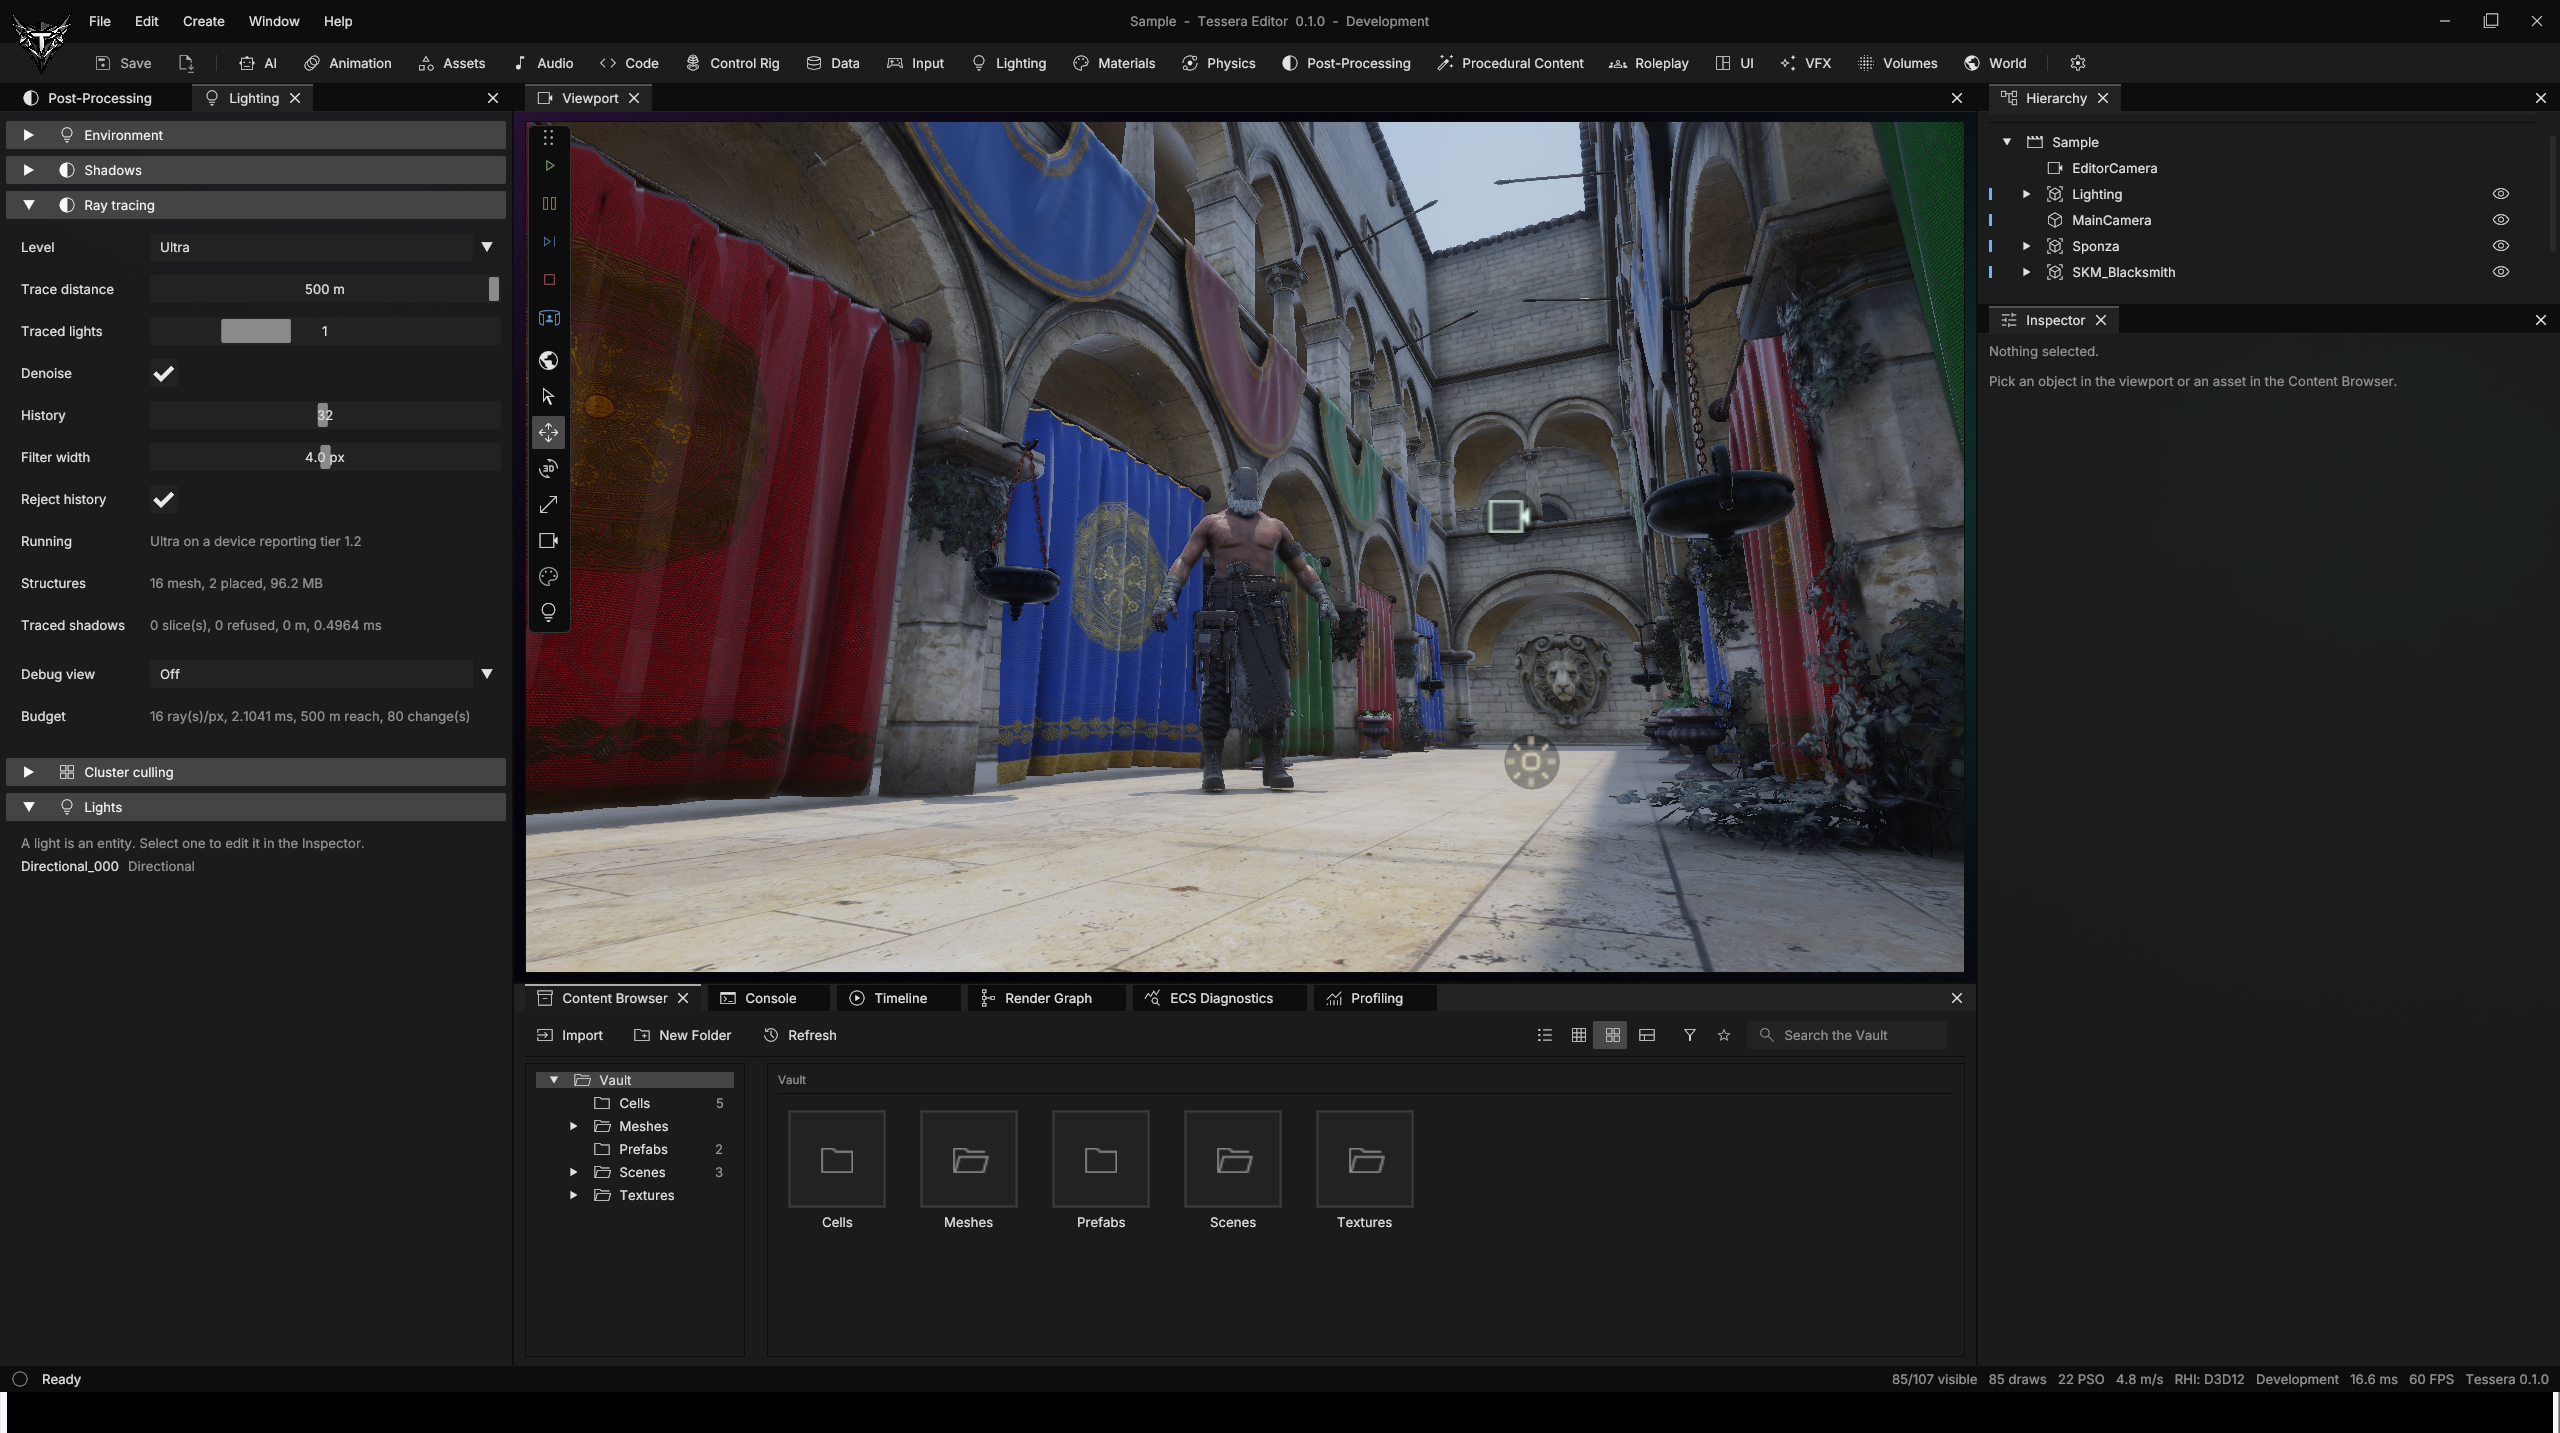
DXR inline con RayQuery ofrece sombras suaves, oclusión ambiental y reflejos trazados, estos limitados a deferred. Un denoiser espacio-temporal y presupuestos adaptativos Low/High/Ultra controlan los efectos en tiempo real. Un path tracer de referencia mide su error. Las capturas muestran la escena de ejemplo y diagnósticos; sus contadores describen esas capturas, no un benchmark para todas las escenas.

Escena de ejemplo Sponza renderizada en el editor Tessera.
Escena de ejemplo Sponza renderizada en el editor Tessera. Abrir original en una pestaña nueva

Autoría

El editor usa los sistemas que muestra

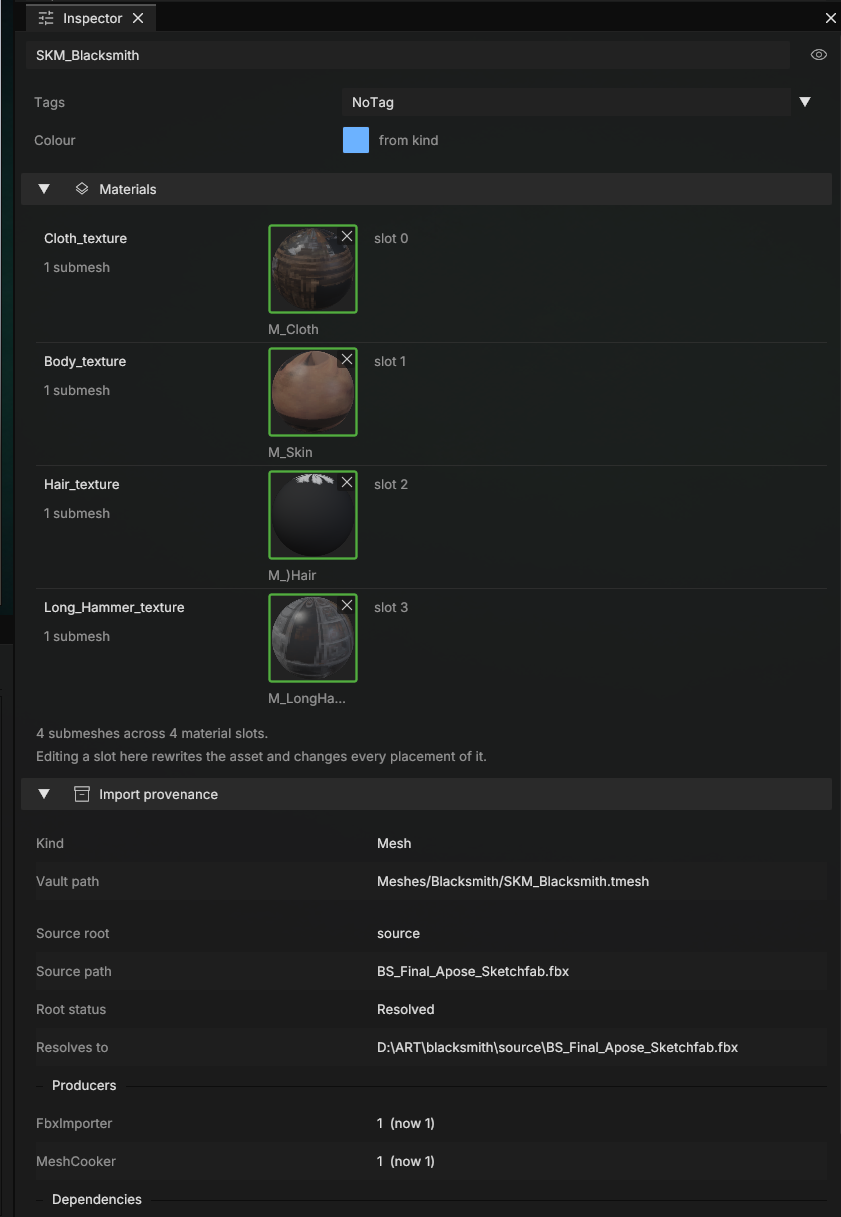
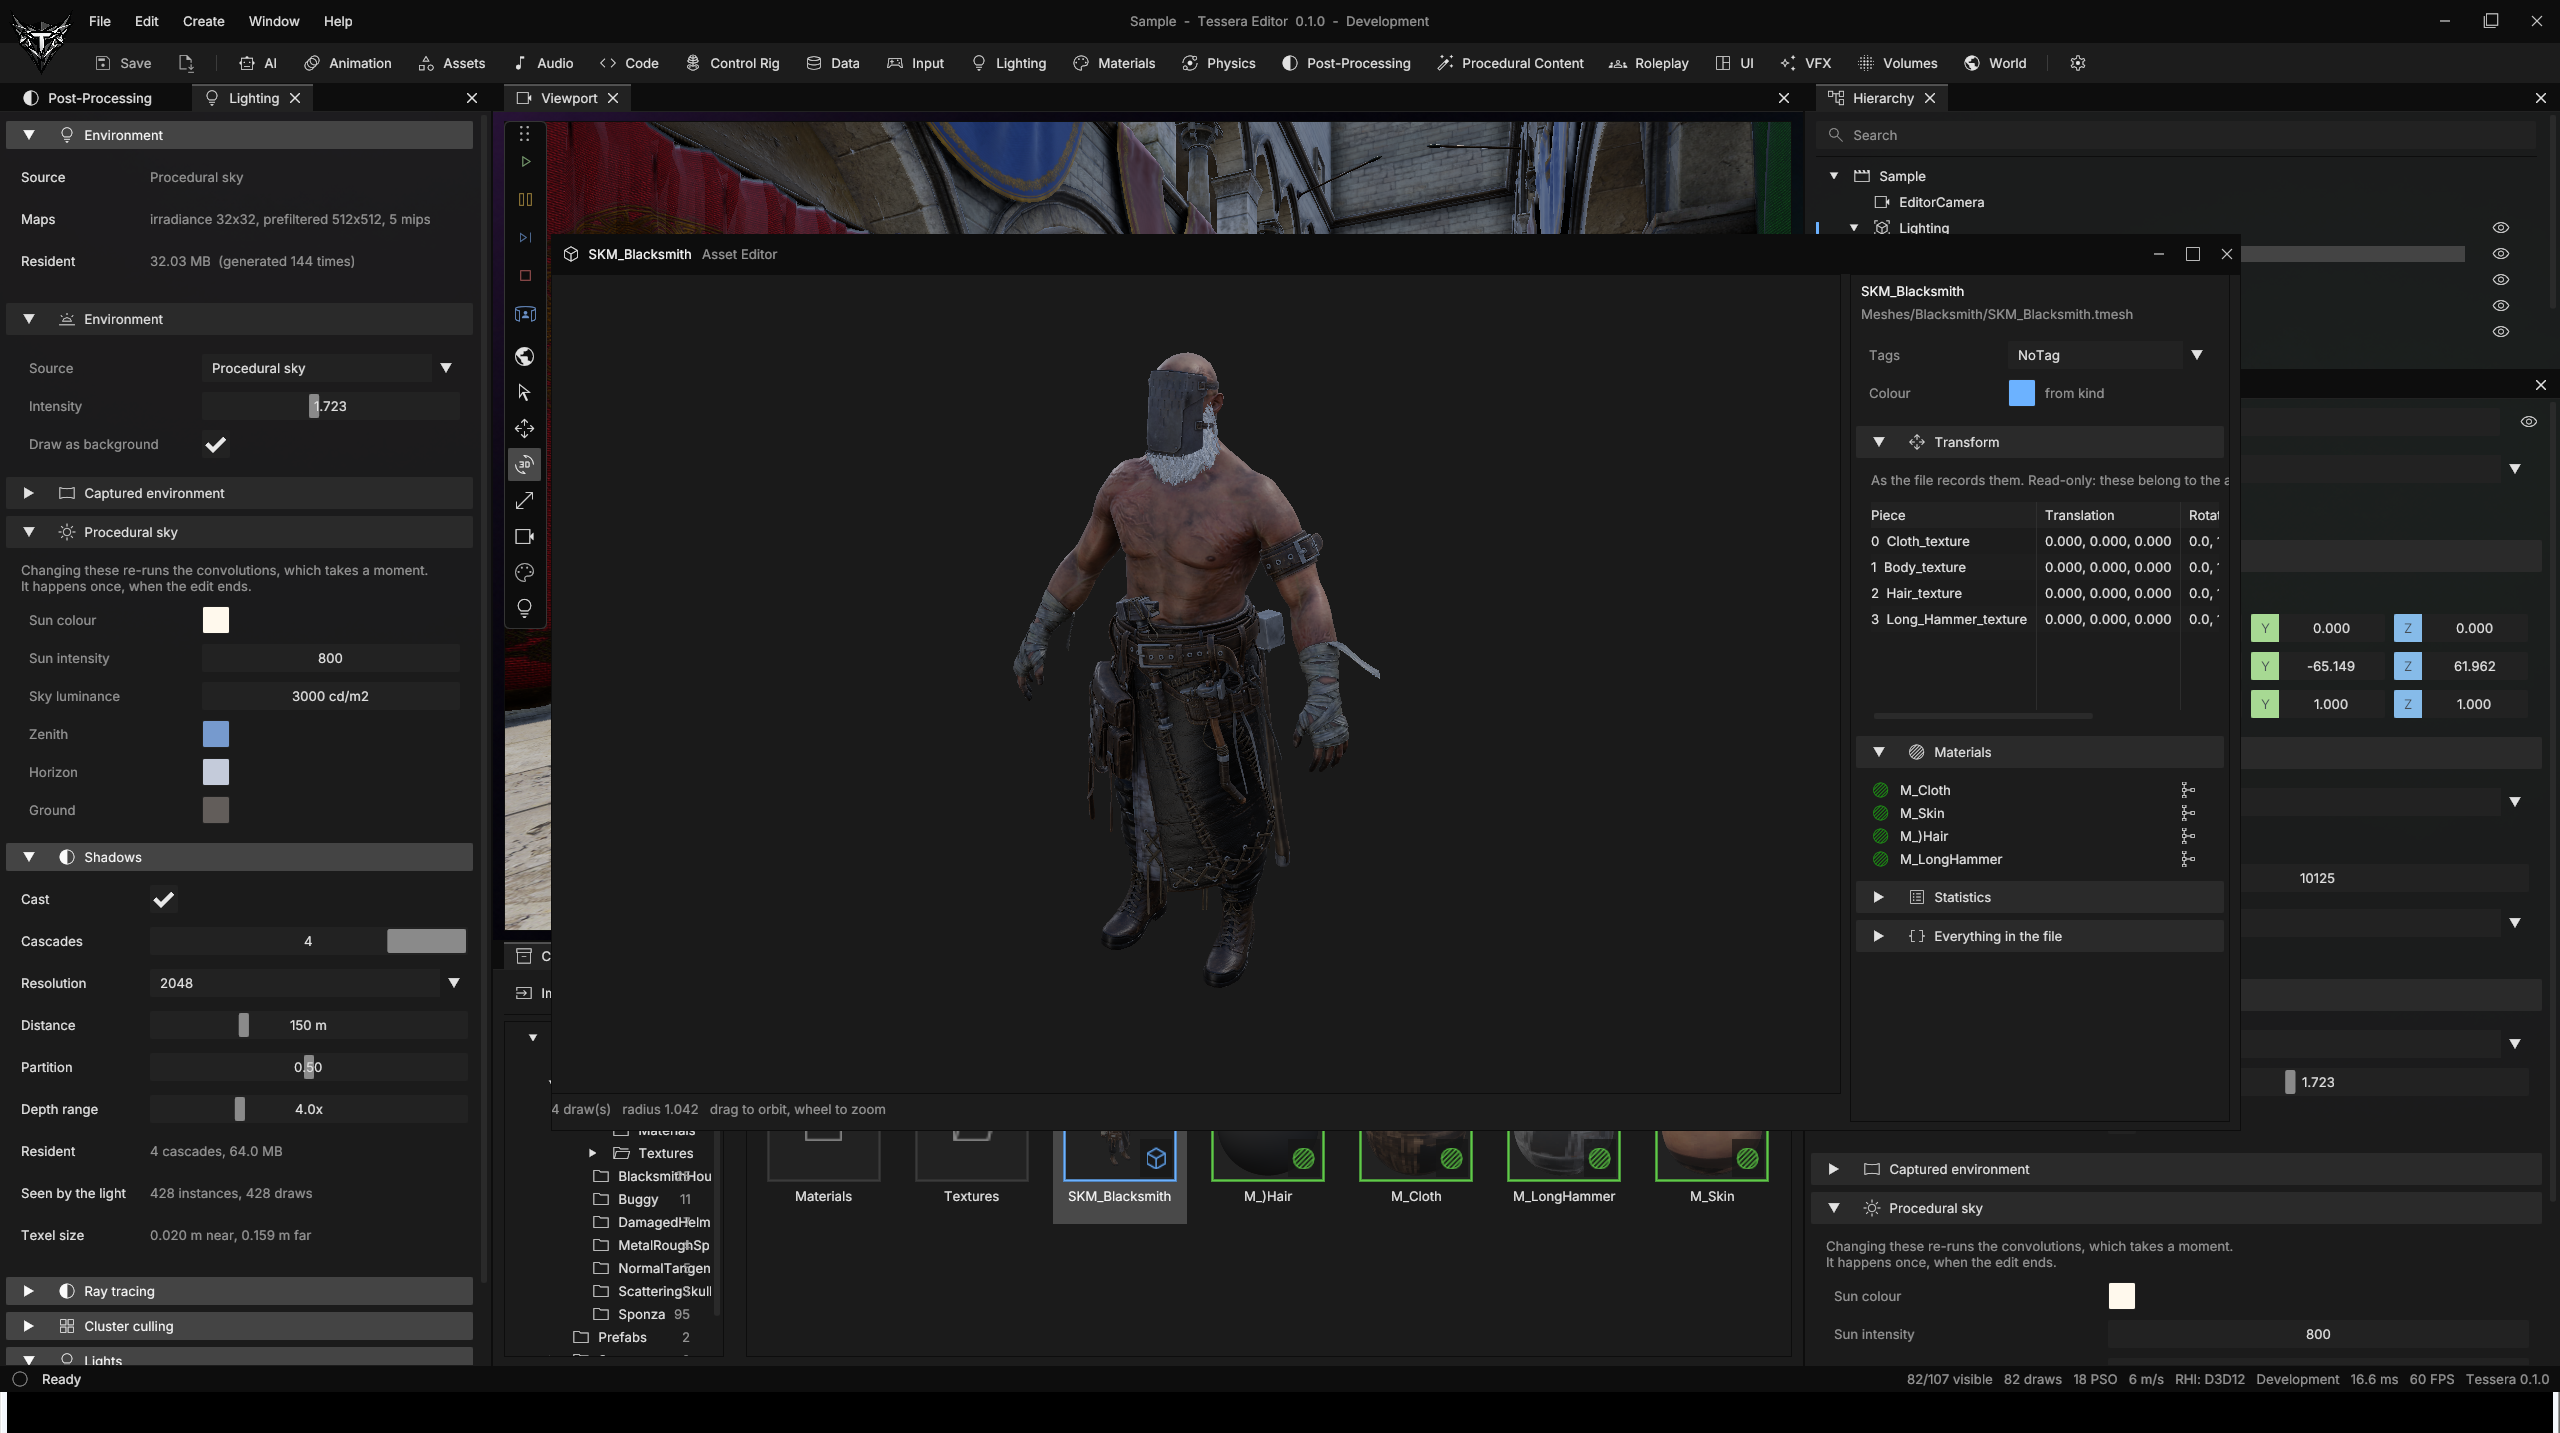
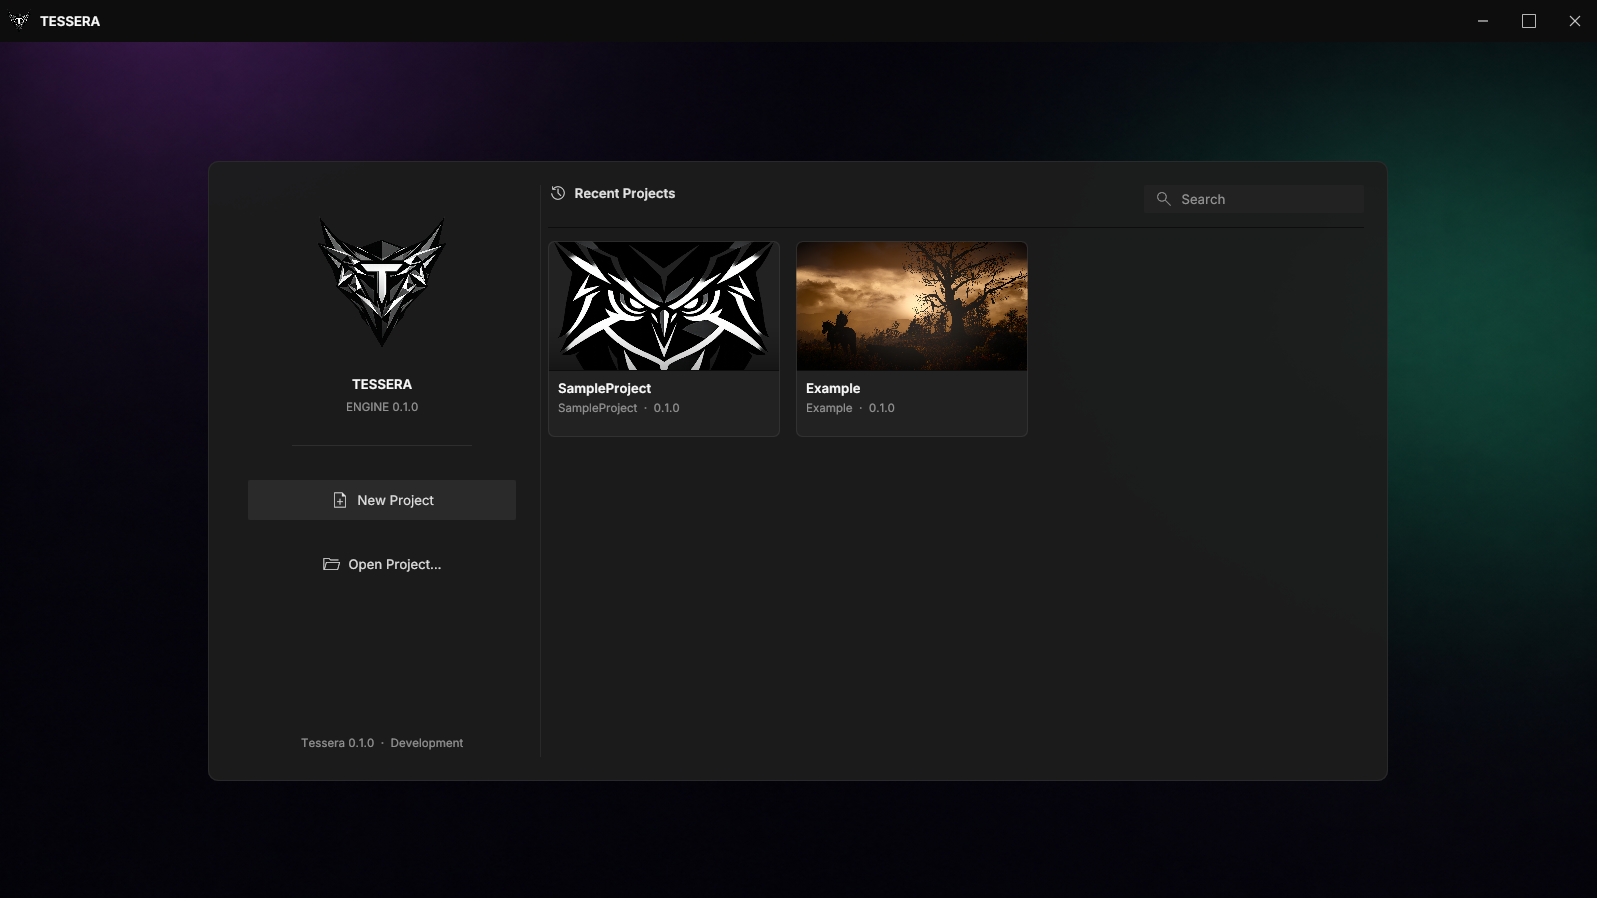
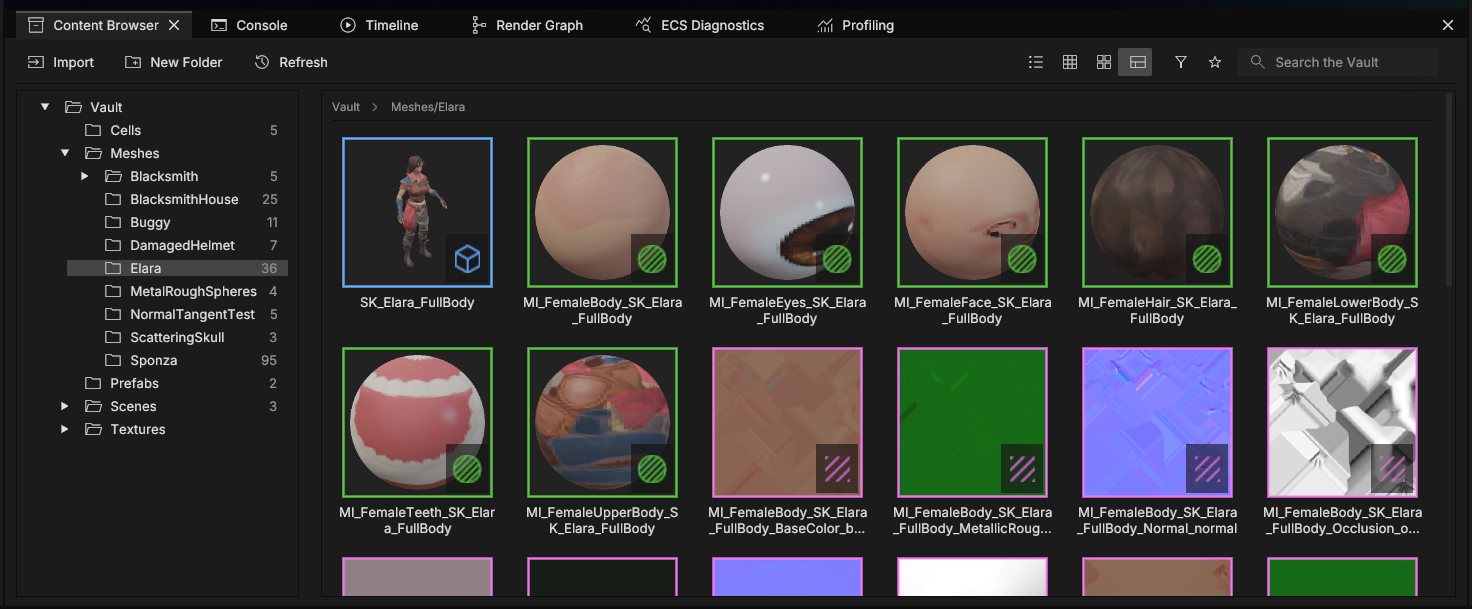
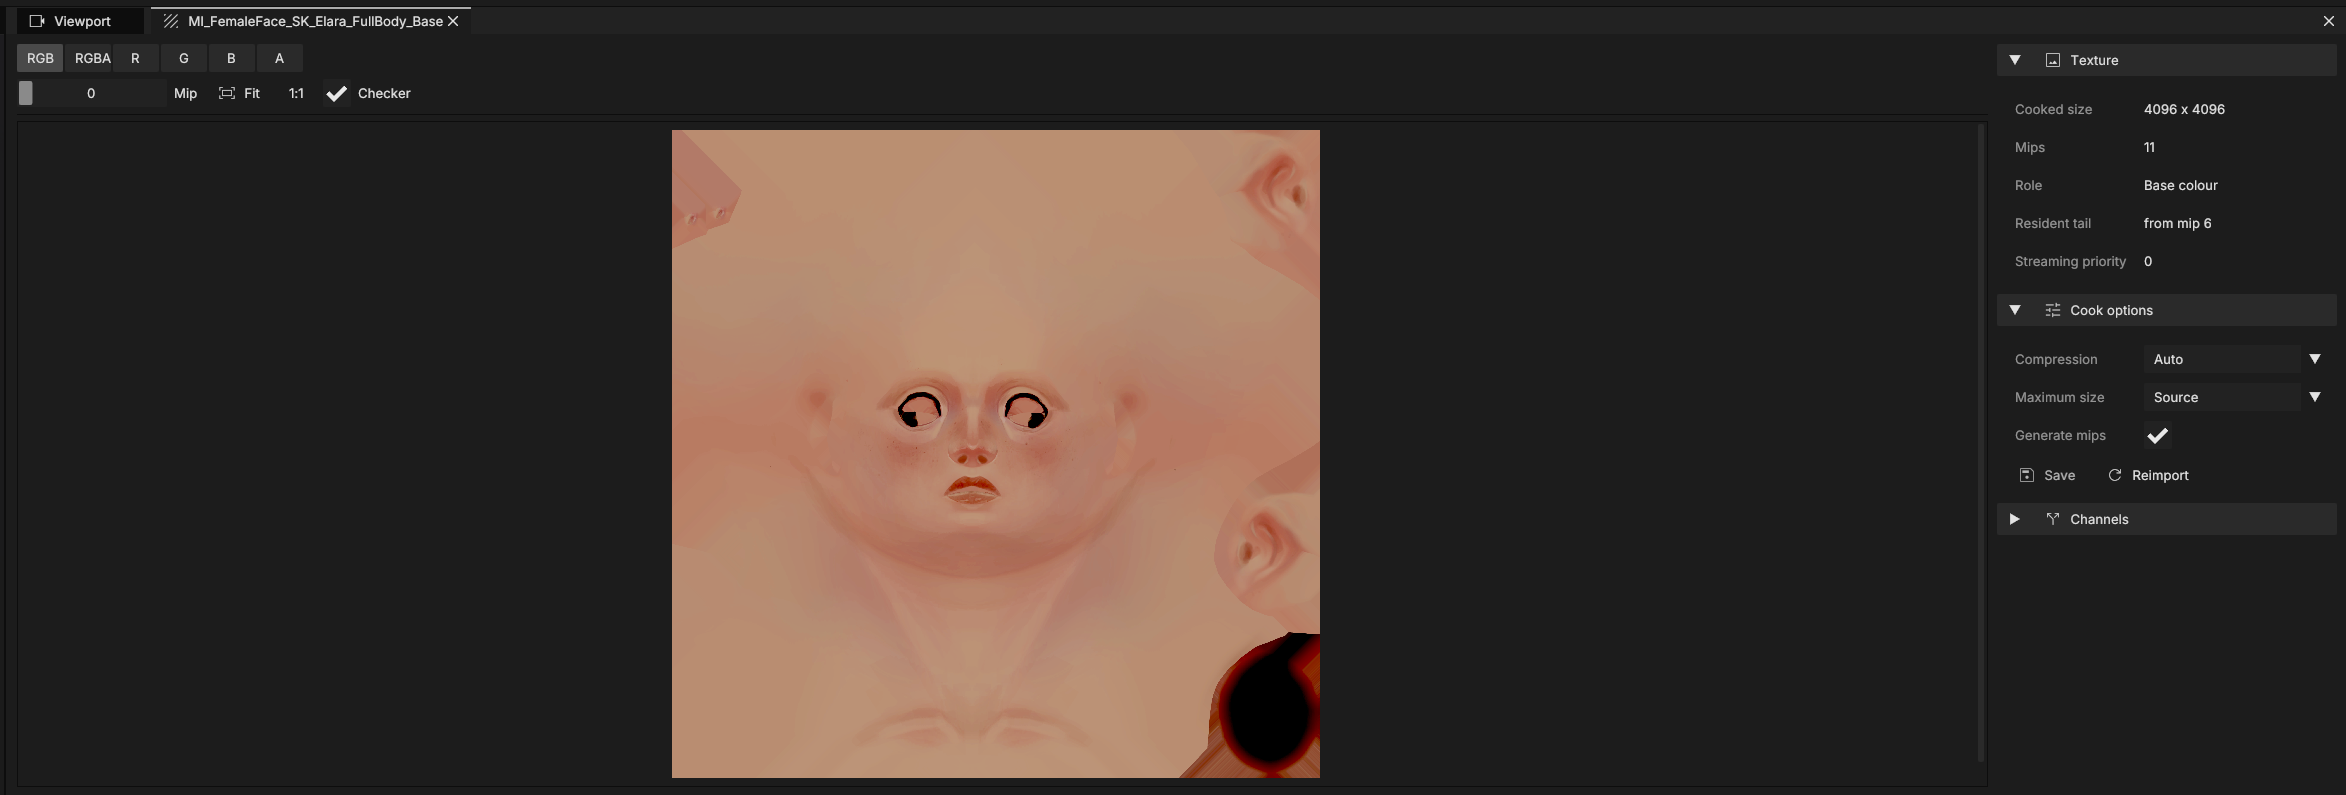
Dear ImGui docking mantiene el editor en C++, dentro del proceso del motor. La Lobby abre un proyecto sin lanzar otra aplicación. El Content Browser tiene miniaturas renderizadas, caché en disco con invalidación automática e imports en segundo plano. Las ventanas de malla/prefab ofrecen previews GPU; el editor de texturas aísla canales y empaqueta ORM. Las propiedades de assets muestran directamente los chunks binarios.

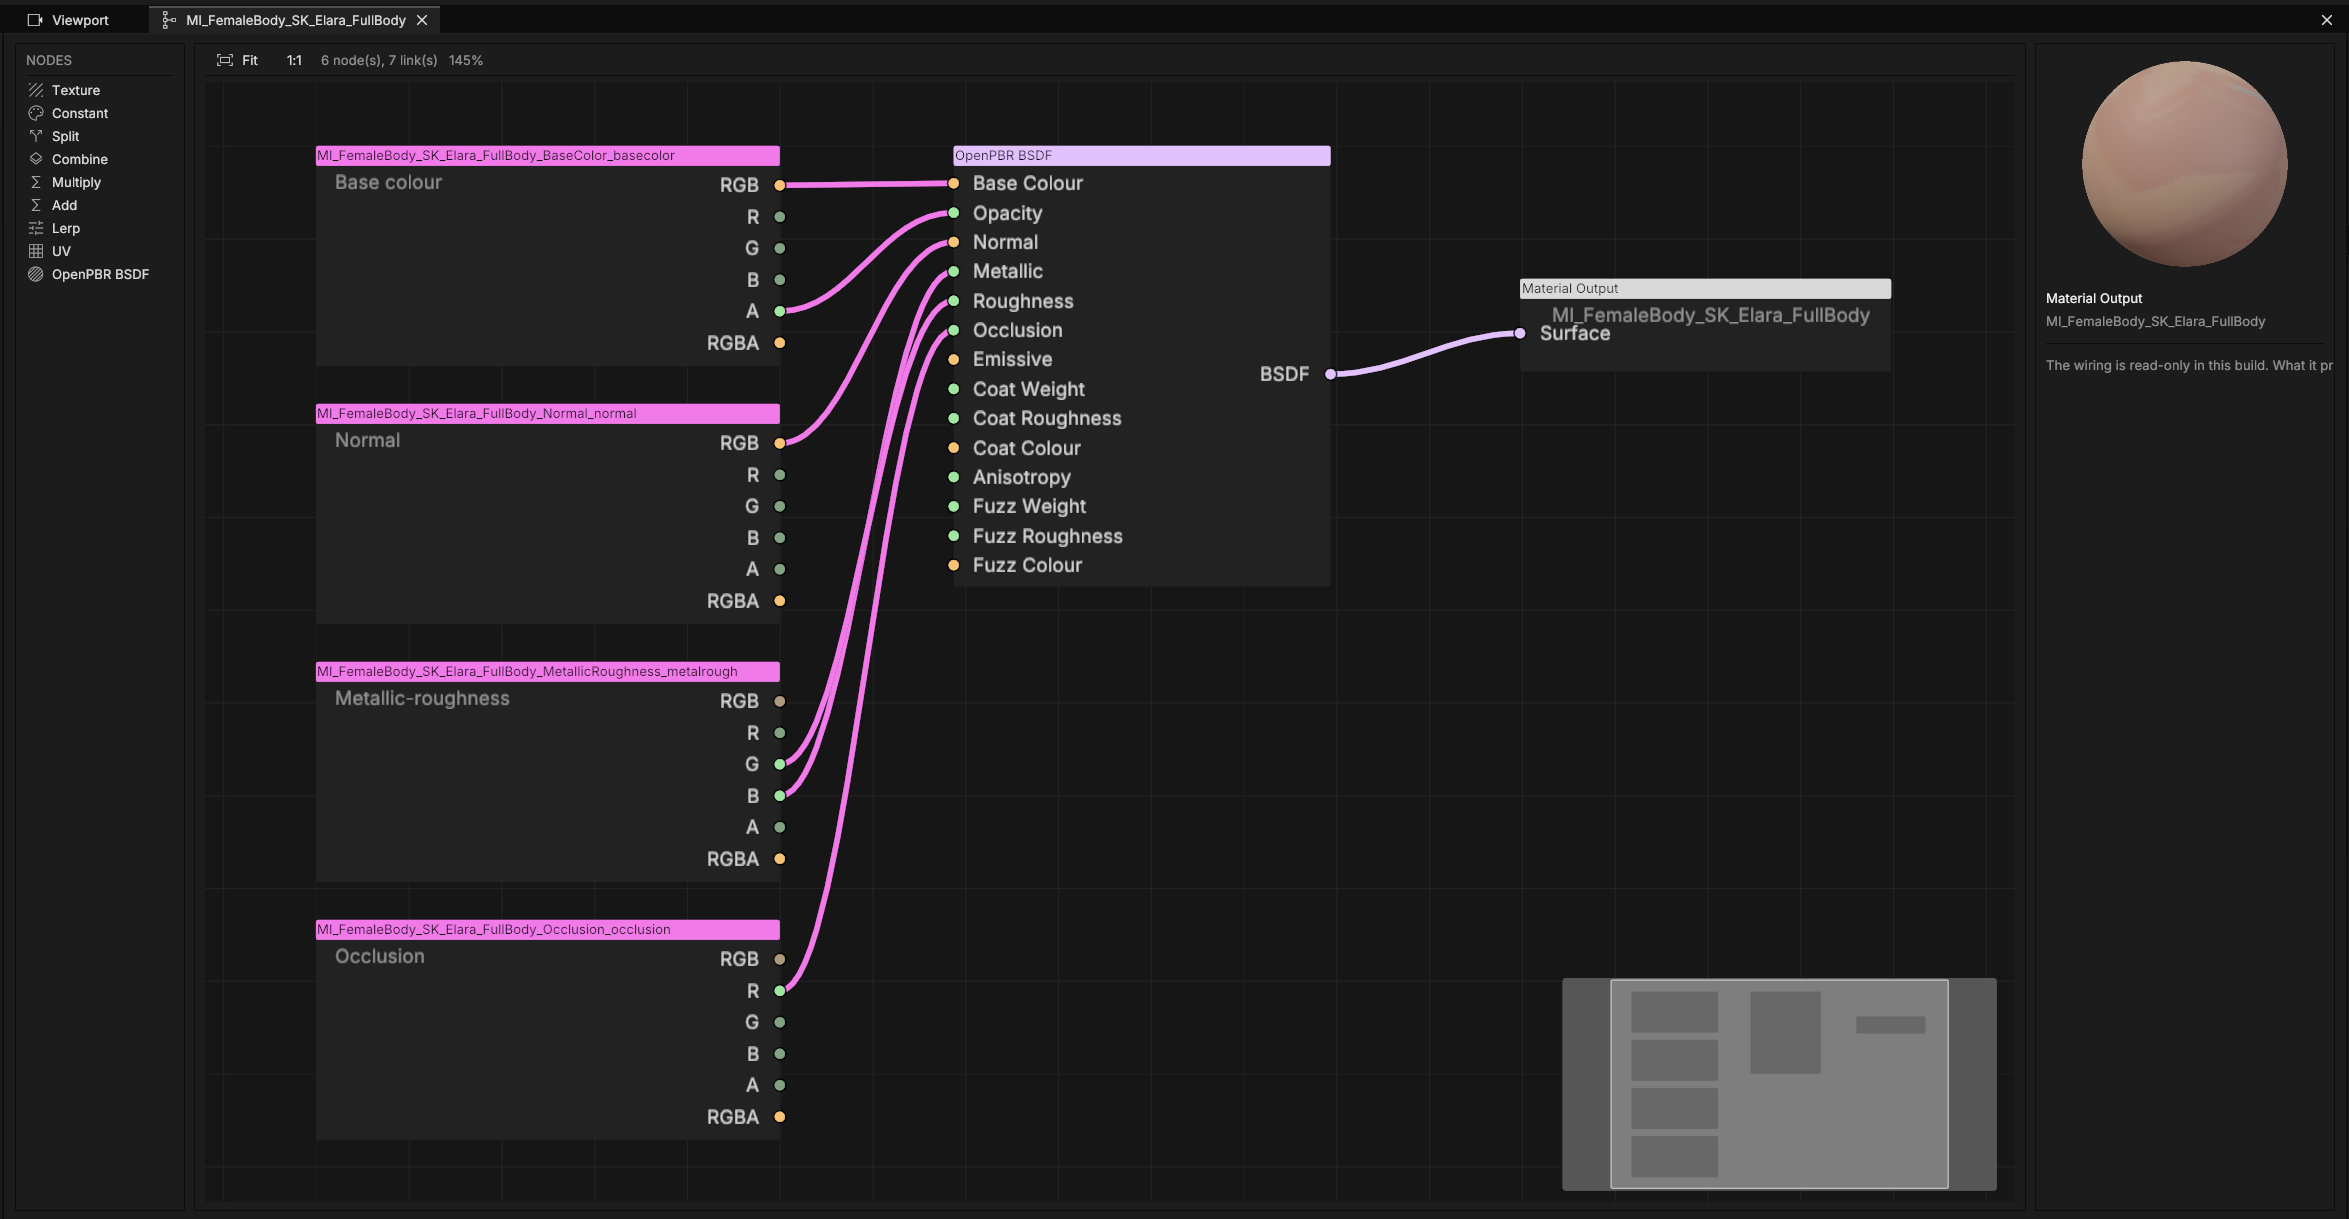
Hierarchy, Inspector, transforms con ImGuizmo, undo/redo, prefabs, tags y colores de assets apoyan la edición de escenas. El Material Graph es una vista de solo lectura derivada de .tmat; sus conexiones no son editables. Los widgets de grafos proceden del GraphEditor de ImGuizmo.

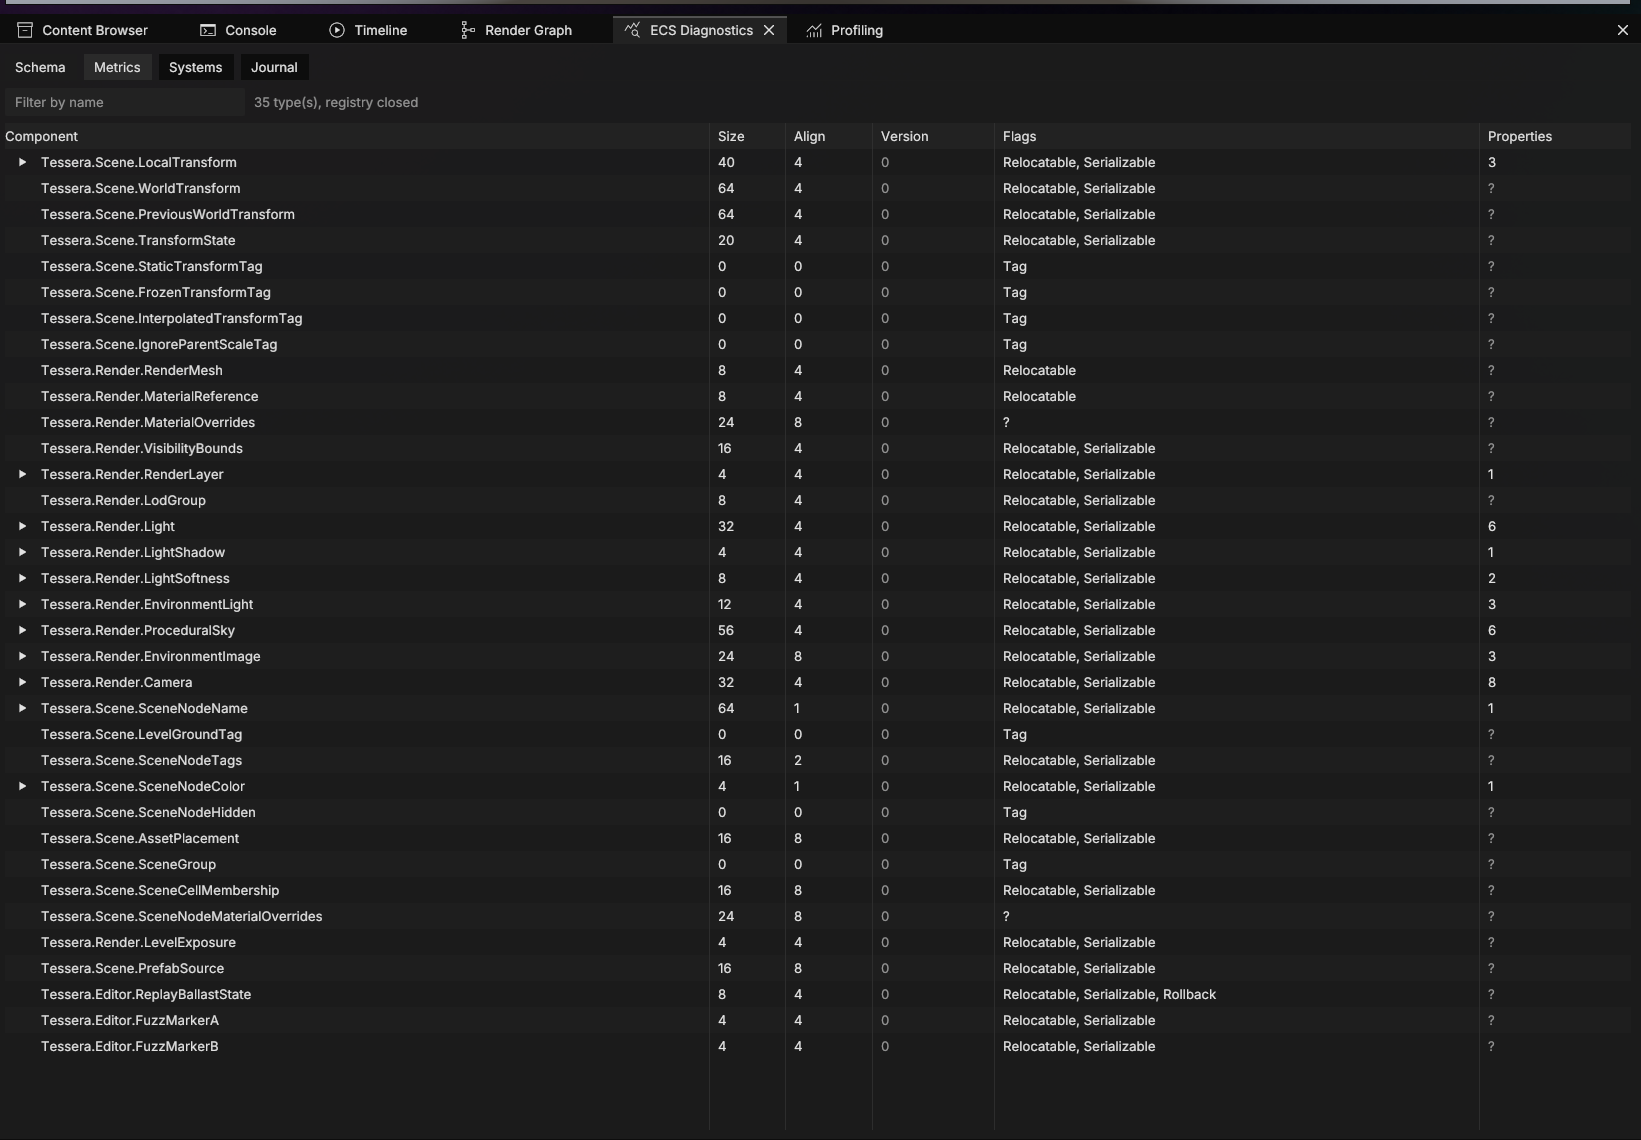
Play, Pause, Stop y Simulate comparten los snapshots: Stop restaura el mundo capturado y verifica un hash idéntico. Las escenas de autoría usan JSON para diffs legibles en Git y se preparan en binario para runtime. Profiling, Render Graph, ECS Diagnostics y Console permiten inspeccionar los sistemas en ejecución desde el editor.

Editor de asset con preview 3D renderizado en GPU.
Editor de asset con preview 3D renderizado en GPU. Abrir original en una pestaña nueva

Decisiones

Dependencias con funciones definidas

Escribo las políticas propias de la engine y uso bibliotecas para problemas delimitados. SDL3 queda detrás de IPlatformBackend; DirectXMath aporta matemáticas SIMD a todo el motor; DXC compila HLSL Shader Model 6.x. Dear ImGui e ImGuizmo ofrecen primitivas de interfaz sin una segunda stack de editor gestionado.

cgltf, ufbx y mi importador OBJ permanecen en el cooker. Elegí ufbx, open source, frente al FBX SDK por su triangulación; mikktspace sigue las convenciones de tangentes de las herramientas artísticas. Entre los compresores evaluados, AMD Compressonator ofreció la calidad BC7 preferida. stb_image y tinyexr decodifican imágenes/HDRI; xxHash identifica contenido preparado; nlohmann/json conserva el orden de claves para diffs estables.

Tracy ofrece timelines CPU/GPU y WinPixEventRuntime nombra los pases GPU en PIX. vcpkg fija versiones por baseline del manifiesto. Antes de añadir una dependencia reviso la licencia de cada componente en su fuente oficial, con preferencia por open source.

Validación

Builds y comparaciones como criterios de diseño

Volví a Sharpmake después de CMake para que un solo generador defina builds en IDE y línea de comandos. Sharpmake y vcpkg producen dos soluciones en Debug, Development, Profile y Shipping: ocho builds locales, todos con advertencias tratadas como errores. Las verificaciones post-build comprueban DLLs de runtime y árboles de shaders replicados.

Los tests sin ventana incluyen 4.883 verificaciones ECS, 242 de render graph y 837 del cooker. Las sondas de línea de comandos ejercitan funciones individuales; un harness compara tiempos y contadores con una baseline. Los diffs de imagen frente a la versión anterior exigen cero píxeles de escena diferentes para los criterios de aceptación de refactorizaciones descritos aquí.

Estas cifras proceden de los registros del proyecto usados para este estudio. Documentan el método y los escenarios medidos, sin representar una nueva ejecución del repositorio privado por este sitio. El build alternativo, las auditorías de replay y las comparaciones de imágenes verifican fallos distintos que un build normal correcto no bastaría para revelar.

En desarrollo

Lo que falta construir

Meshlets y mesh shaders son los siguientes pasos del renderizado. Jolt Physics, miniaudio, GameNetworkingSockets y Recast & Detour son dependencias elegidas, todavía no integradas. Un servidor autoritativo para 16 jugadores es un objetivo; snapshots con alcance de replicación y una medición de precisión para mundos de hasta 200 km² son la base, pero la red aún no se ha empezado.

Upscaling temporal, TAA y motion blur siguen pendientes. Async compute está implementado, es opcional y está desactivado por defecto; su ganancia medida fue de aproximadamente 2%, por debajo del umbral de 5% para justificar activarlo. La iluminación global no está implementada. Windows es la única plataforma compatible.

También quedan cuestiones de ciclo de vida: cambiar de proyecto en el mismo proceso aún acumula mallas en memoria GPU. Lo considero trabajo pendiente. Estas notas hacen visibles tanto la arquitectura implementada como sus límites actuales.

Contacto

Ciudad de Québec, QC, Canadá / Disponible para oportunidades

Estoy abierto a oportunidades en desarrollo de software, programación de herramientas y gameplay, así como a puestos de artista 3D junior. Si mi experiencia encaja con tu equipo, estaré encantado de conversar a través de mis perfiles sociales.